Ra mắt bộ kiểm thử bảo mật Agentic AI với 222 kịch bản tấn công chuyên sâu
Chuyên gia bảo mật vừa công bố bộ checklist 222 bài kiểm thử dành cho hệ thống AI tự hành, mở rộng phạm vi từ prompt injection sang hạ tầng, cloud và chuỗi cung ứng.

- Phạm vi toàn diện: Bộ checklist bao gồm 222 bài kiểm thử chia thành 20 danh mục tấn công, vượt xa các phương pháp kiểm thử prompt injection truyền thống.
- Tiếp cận đa tầng: Đánh giá bảo mật từ hạ tầng, quyền truy cập cloud, công cụ (tools), bộ nhớ (memory) cho đến giao thức truyền thông giữa các agent.
- Cấu trúc chuẩn hóa: Dựa trên khung tham chiếu OWASP Web Security Testing Guide, hỗ trợ các đội ngũ Red Team định lượng rủi ro và ghi nhận bằng chứng kỹ thuật.
Trong bối cảnh các hệ thống AI tự hành (Agentic AI) ngày càng phổ biến, việc chỉ tập trung vào các kỹ thuật tấn công prompt injection là chưa đủ để đảm bảo an toàn cho toàn bộ hệ sinh thái. Một bộ checklist mới được công bố bởi nhà nghiên cứu bảo mật Ravi Rajput đã cung cấp 222 bài kiểm thử chi tiết, giúp các đội ngũ Red Team đánh giá khả năng chống chịu của hệ thống AI trước các mối đe dọa phức tạp.
Cấu trúc 20 danh mục tấn công trong Agentic AI
Bộ checklist này được thiết kế để lấp đầy khoảng trống trong quy trình kiểm thử hiện nay, nơi các đội ngũ thường bỏ qua các lỗ hổng hạ tầng như máy chủ MLflow bị lộ, endpoint metadata cloud có thể truy cập được, hoặc thiếu bộ lọc phân tách khách hàng (customer-isolation filter). Những điểm yếu này có thể dẫn đến việc rò rỉ thông tin xác thực và dữ liệu nhạy cảm mà không cần phải tấn công trực tiếp vào mô hình AI.
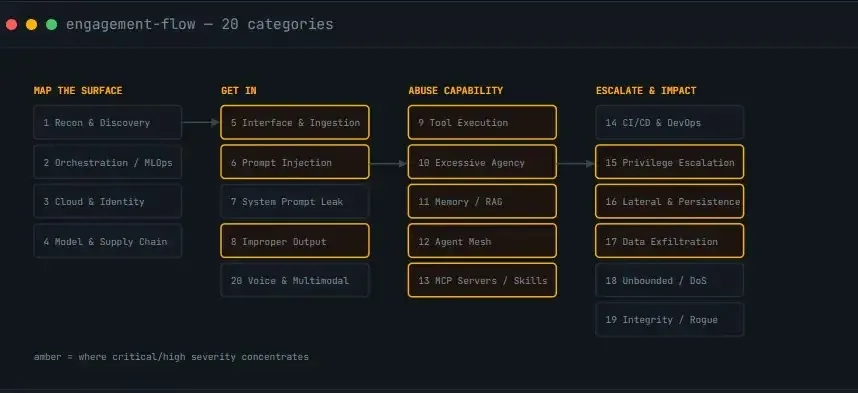
Quy trình kiểm thử được chia thành 4 giai đoạn chiến lược, giúp người thực hiện hiểu rõ khả năng tiếp cận của agent trước khi đánh giá tác động của các chỉ dẫn độc hại:
- Giai đoạn 1 (Mapping): Tập trung vào khám phá bề mặt tấn công, điều phối (orchestration), danh tính cloud và chuỗi cung ứng mô hình.
- Giai đoạn 2 (Input & Logic): Kiểm tra các đầu vào, kỹ thuật prompt injection, rò rỉ system prompt và xử lý đầu ra không an toàn.
- Giai đoạn 3 (Tools & Memory): Thử nghiệm các công cụ, quyền hạn quá mức (excessive agency), bộ nhớ, mạng lưới agent và các máy chủ Model Context Protocol (MCP).
- Giai đoạn 4 (Post-Exploitation): Đánh giá các đường ống triển khai (deployment pipelines), leo thang đặc quyền, di chuyển ngang (lateral movement), duy trì sự hiện diện (persistence), đánh cắp dữ liệu và cạn kiệt tài nguyên.
Phân tích kỹ thuật và đánh giá rủi ro
Điểm đáng chú ý của bộ tài liệu này là cách phân loại mức độ nghiêm trọng dựa trên các kịch bản thực tế. Trong số 222 bài kiểm thử, có 75 bài được xếp hạng Critical, 108 bài High, 30 bài Medium và 9 bài Low. Đây là các mức độ đề xuất dựa trên tiềm năng khai thác, không phải là bằng chứng về lỗ hổng cụ thể trong một sản phẩm nhất định.
| Loại rủi ro | Ví dụ kỹ thuật | Tác động tiềm tàng |
|---|---|---|
| Cloud Credential Theft | Khai thác SSRF để truy xuất metadata | Chiếm đoạt quyền truy cập tài nguyên cloud |
| Remote Code Execution | Tải tệp Python pickle không an toàn | Chiếm quyền điều khiển máy chủ thực thi |
| Data Exfiltration | Kết hợp công cụ để chuyển dữ liệu trái phép | Rò rỉ thông tin khách hàng nhạy cảm |
| Cross-Tenant Access | Vượt qua bộ lọc định danh khách hàng | Truy cập trái phép dữ liệu của người dùng khác |
Đối với các hệ thống bộ nhớ và truy xuất (RAG), bộ checklist đặc biệt chú trọng vào việc kiểm tra ranh giới giữa các khách hàng. Thay vì chỉ đặt câu hỏi liệu mô hình có đưa ra câu trả lời không an toàn hay không, các bài kiểm thử tập trung vào việc liệu việc loại bỏ bộ lọc định danh khách hàng có làm lộ tài liệu của bên thứ ba hay không.
Khuyến nghị cho đội ngũ Red Team
Để triển khai hiệu quả, các nhà nghiên cứu khuyến nghị đội ngũ cần xác định phạm vi (scope) bằng văn bản trước khi bắt đầu, đánh dấu các mục kiểm thử bị loại trừ và ghi lại nhật ký hoặc ảnh chụp màn hình làm bằng chứng cho mỗi kết quả. Các bài kiểm thử mang tính phá hoại (destructive checks) chỉ nên được thực hiện trong môi trường staging và khi có sự cho phép rõ ràng.
Một tính năng quan trọng khác là hệ thống phân loại bằng chứng (evidence classification):
- Reflective: Kết quả xuất hiện trực tiếp trong phản hồi của mô hình.
- Blind: Dựa trên sự thay đổi về thời gian phản hồi hoặc trạng thái hệ thống.
- Out-of-band: Sử dụng callback được kiểm soát để xác nhận lỗ hổng.
Việc áp dụng khung tham chiếu từ OWASP và MITRE ATLAS giúp bộ checklist này trở thành một công cụ mạnh mẽ cho các chuyên gia an ninh mạng trong việc xây dựng quy trình kiểm thử AI tự hành có hệ thống và minh bạch.
Mạng Lưới An Ninh Mạng & Cộng Đồng
Nhận cảnh báo 0-Day khẩn cấp, phân tích mã độc và tham gia thảo luận kỹ thuật cùng chuyên gia.
Ban biên tập nội dung và phân tích an ninh mạng tại ADSECVN.COM.
Bài Viết Liên Quan