Anthropic mở rộng quyền truy cập AI cho chuyên gia bảo mật sau phát hiện 129.000 lỗ hổng
Anthropic nâng cấp chương trình Cyber Verification Program (CVP), cho phép các chuyên gia bảo mật thử nghiệm mô hình AI với ít rào cản hơn sau khi dự án Glasswing phát hiện 129.000 lỗ hổng phần mềm.

- Mở rộng quyền truy cập: Anthropic chính thức triển khai Cyber Verification Program (CVP) với ba cấp độ truy cập khác nhau cho các chuyên gia an ninh mạng.
- Kết quả dự án Glasswing: Hơn 129.000 lỗ hổng phần mềm đã được xác minh từ tháng 4 đến tháng 7 năm 2026, với hơn 33.000 lỗ hổng được xếp hạng nghiêm trọng hoặc cao.
- Thực trạng khai thác: Dữ liệu từ VulnCheck cho thấy chỉ 0,67% trong số các lỗ hổng được AI phát hiện đã bị khai thác thực tế trong môi trường sản xuất.
- Rủi ro từ AI: Các nghiên cứu cảnh báo rằng việc sử dụng AI để tạo mã nguồn có thể vô tình đưa thêm các lỗ hổng bảo mật mới vào hệ thống.
Anthropic vừa công bố việc mở rộng chương trình cho phép các chuyên gia an ninh mạng đã qua kiểm duyệt được quyền truy cập vào các mô hình trí tuệ nhân tạo (AI) tiên tiến của hãng với các rào cản bảo mật và bộ phân loại chặn (blocking classifiers) được giảm thiểu. Động thái này diễn ra trong bối cảnh dự án Project Glasswing của công ty đã ghi nhận con số ấn tượng với ít nhất 129.000 lỗ hổng phần mềm được xác minh trong khoảng thời gian từ tháng 4 đến tháng 7 năm 2026.
Bên cạnh đó, công ty cũng cho biết đã phát hiện thêm 5.500 lỗ hổng phần mềm đã được xác minh khác trong giai đoạn từ tháng 4 đến tháng 10 năm 2026 thông qua các nỗ lực quét mã nguồn mở. Theo đại diện của Anthropic, trong số các lỗ hổng đã được xác minh, có hơn 33.000 lỗ hổng được đánh giá ở mức độ nghiêm trọng (critical) hoặc cao (high). Đáng chú ý, đây có thể chỉ là con số ước tính thấp hơn thực tế do dữ liệu khảo sát chỉ dựa trên một nhóm nhỏ các đối tác của Glasswing, và tác động thực tế dự kiến có thể cao gấp ít nhất năm lần.
Chi tiết về chương trình Cyber Verification Program (CVP)
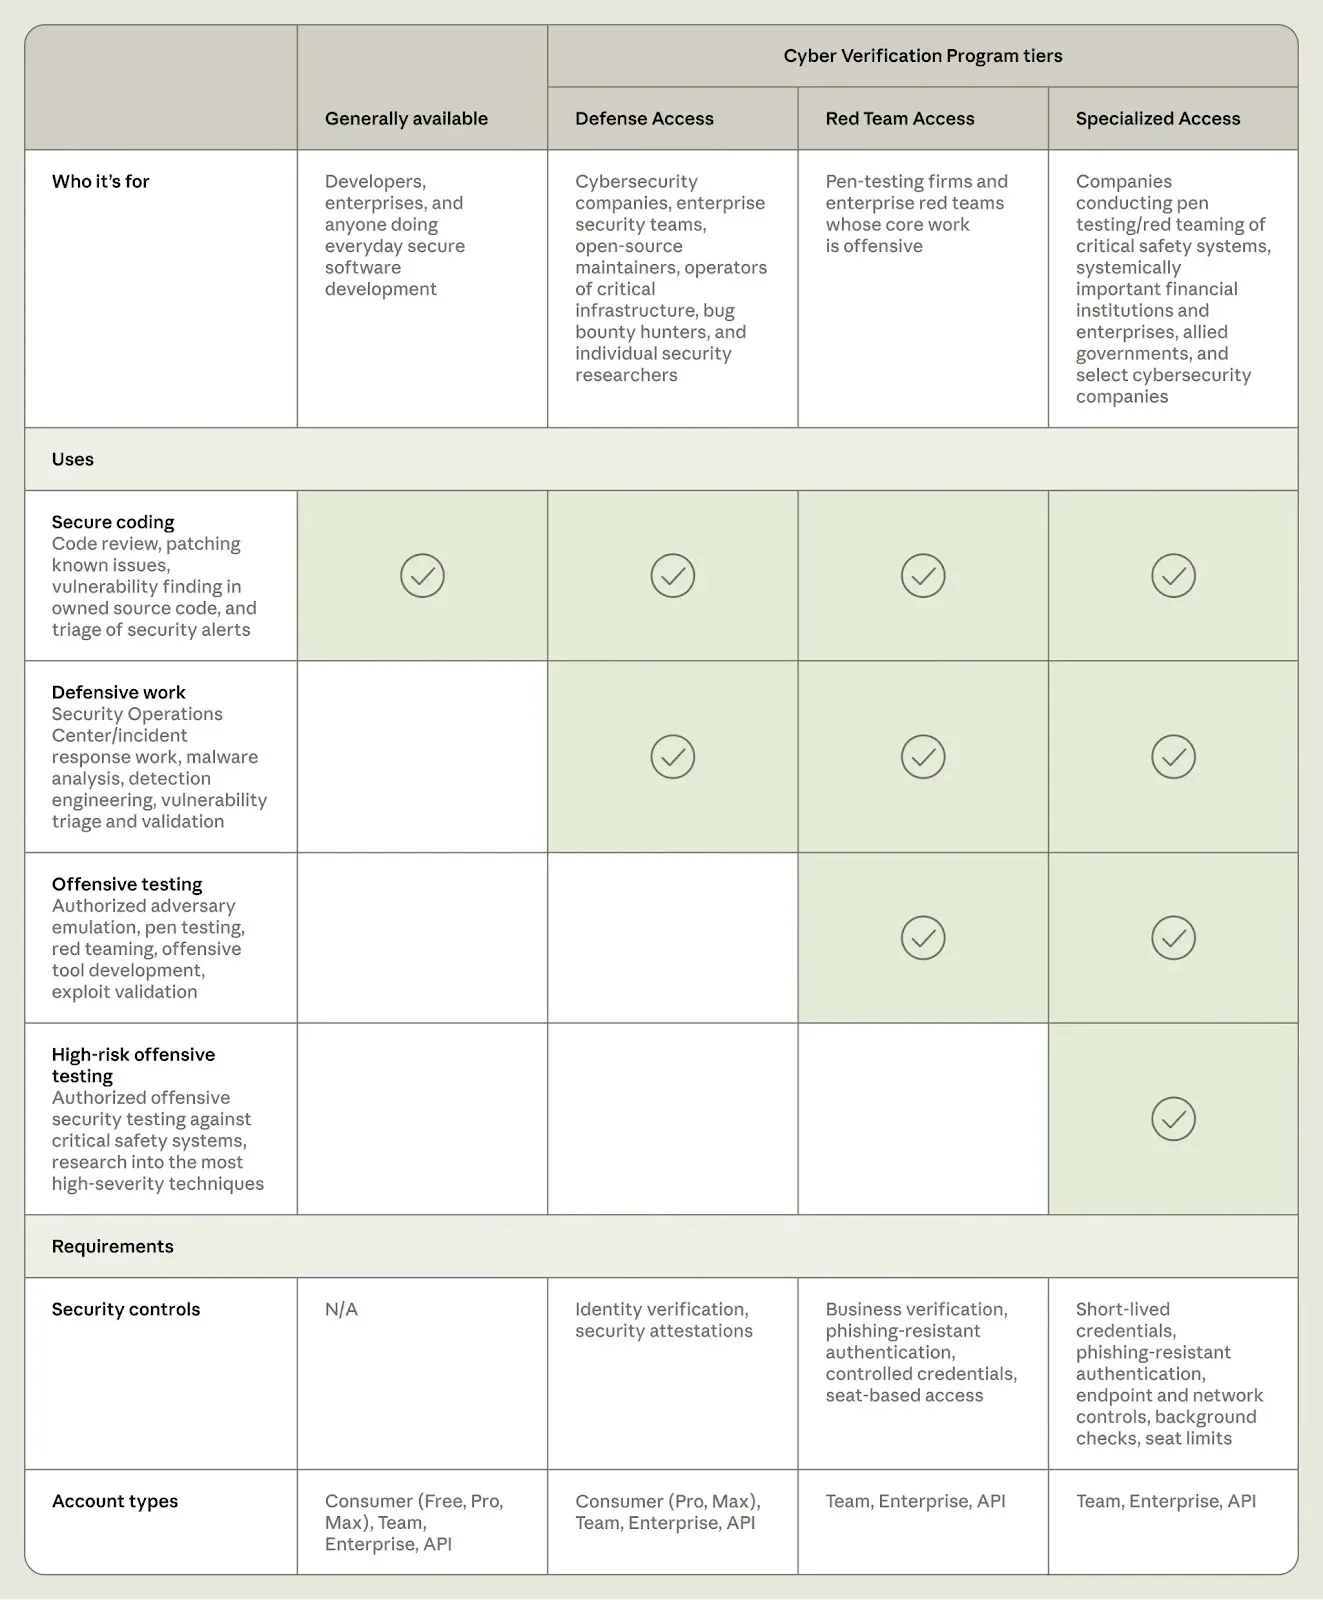
Chương trình CVP được cập nhật với ba cấp độ truy cập, cho phép các tổ chức và đội ngũ bảo mật lựa chọn cấp độ phù hợp nhất với nhu cầu công việc của họ. Mỗi cấp độ cung cấp quyền truy cập vào các mô hình AI bao gồm Claude Opus 5.5, Claude Sonnet 5.5, Claude Mythos 5.1 và các mô hình mới trong tương lai.
- Defense Access: Dành cho các công việc phòng thủ như phản ứng sự cố (incident response), dịch ngược mã độc (malware reverse engineering), và phân tích, xác thực lỗ hổng.
- Red Team Access: Bổ sung thêm các hoạt động kiểm thử xâm nhập (penetration testing) và red-teaming bên cạnh các trường hợp sử dụng phòng thủ.
- Specialized Access: Cấp độ có ít rào cản bảo mật nhất, dành riêng cho một nhóm hạn chế các tổ chức đã được xác minh, có thẩm quyền kiểm thử các hệ thống an toàn.
Theo đánh giá từ CyScenarioBench, các rào cản bảo mật đã chặn 46 trong số 50 tác vụ trên mô hình Claude Opus 5.5 ở cấp độ Defense Access. Ngược lại, cấp độ Red Team Access trên cùng mô hình không chặn bất kỳ tác vụ nào và hoàn thành 34 trên 50 tác vụ, tương đương với tỷ lệ hoàn thành khi không áp dụng bất kỳ rào cản bảo mật nào. Trong khi đó, nếu không có quyền truy cập CVP, mọi tác vụ đều bị chặn ngay từ câu lệnh (prompt) đầu tiên.
Phân tích thực trạng khai thác lỗ hổng
Anthropic khẳng định rằng việc cung cấp các công cụ này cho đội ngũ phòng thủ xuất phát từ tính chất "sử dụng kép" (dual-use) của AI, nhằm giúp họ bảo vệ hệ thống bằng chính những khả năng mà kẻ tấn công có thể lợi dụng cho mục đích xấu. Trong một phân tích được công bố vào cuối tháng trước, nhà nghiên cứu Patrick Garrity từ VulnCheck tiết lộ rằng chỉ có 2 trong số 300 lỗ hổng được Anthropic hoặc Project Glasswing phát hiện (tương đương 0,67%) đã bị khai thác trong thực tế.
| Loại thực thể | Giá trị / Chỉ số | Mô tả tác động |
|---|---|---|
| CVE-2026-26980 | SQL Injection | Lỗ hổng trong Ghost CMS đã bị khai thác thực tế. |
| CVE-2026-61500 | Session Forgery | Lỗ hổng trong Rejetto HTTP File Server đã bị khai thác thực tế. |
Trong số các lỗ hổng được phân tích, có 39 lỗ hổng được phân loại là nghiêm trọng, 141 lỗ hổng ở mức cao, 81 lỗ hổng ở mức trung bình và 18 lỗ hổng ở mức thấp. Những phát hiện này cho thấy mặc dù AI đang làm giảm rào cản trong việc phát hiện lỗ hổng, nhưng không phải mọi lỗ hổng mà AI tìm thấy đều có khả năng bị kẻ tấn công khai thác hoặc gây ra tác động đáng kể.
⚠️ Cảnh báo quan trọng: Các nghiên cứu từ 1Password và Veracode cảnh báo rằng việc sử dụng AI để tạo bản vá lỗ hổng có thể vô tình tạo ra các rủi ro bảo mật mới. Khoảng 44% các tác vụ tạo mã bằng AI đã đưa vào các lỗ hổng bảo mật rủi ro trong quá trình thử nghiệm. Tỷ lệ vượt qua kiểm tra bảo mật trung bình trên các mô hình chỉ đạt 56%, cho thấy hiệu suất bảo mật của mã do AI tạo ra vẫn chưa có sự cải thiện đáng kể trong khi khối lượng mã này đang tăng vọt trong các quy trình phát triển phần mềm.
Việc cân bằng giữa khả năng hỗ trợ của AI và rủi ro tiềm ẩn từ mã nguồn do AI tạo ra vẫn là một thách thức lớn đối với các đội ngũ kỹ thuật. Các tổ chức cần duy trì quy trình kiểm soát chất lượng nghiêm ngặt và kiểm tra bảo mật thủ công đối với mọi đoạn mã được tạo ra bởi AI trước khi triển khai vào môi trường sản xuất để đảm bảo an toàn hệ thống.
Mạng Lưới An Ninh Mạng & Cộng Đồng
Nhận cảnh báo 0-Day khẩn cấp, phân tích mã độc và tham gia thảo luận kỹ thuật cùng chuyên gia.
Ban biên tập nội dung và phân tích an ninh mạng tại ADSECVN.COM.
Bài Viết Liên Quan