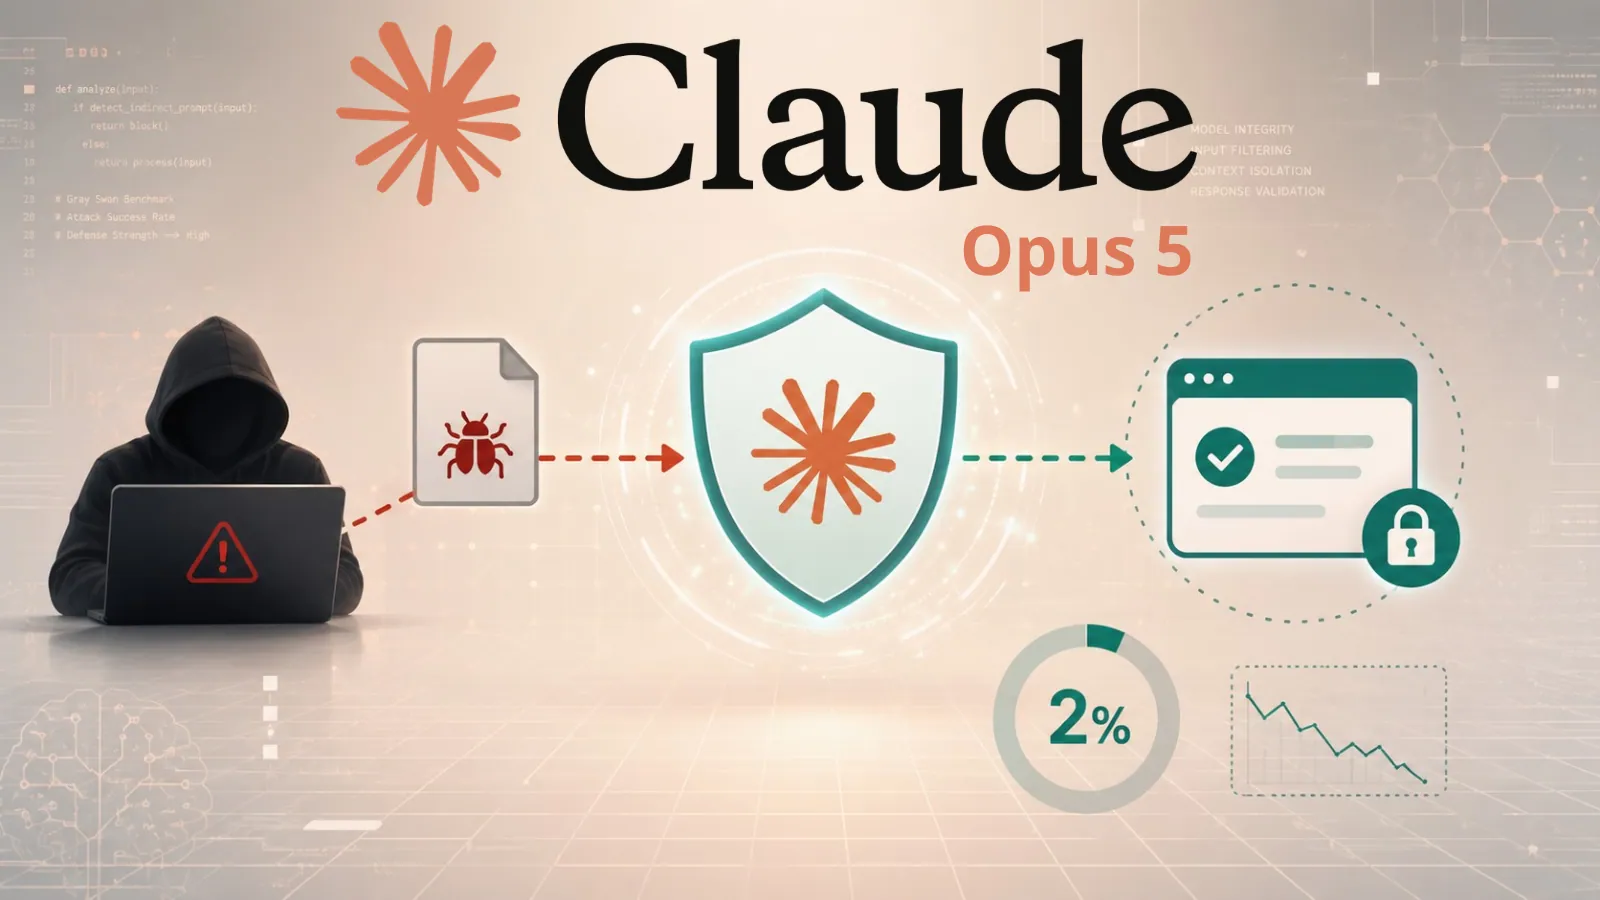
Anthropic’s Claude Opus 5 đã ghi nhận tỷ lệ thành công thấp nhất trong các cuộc tấn công mạng gián tiếp vào prompt, theo kết quả từ bảng xếp hạng mới nhất của Gray Swan. Kết quả này được cung cấp trong thẻ hệ thống của Opus 5.
Claude Opus 5 Giảm Thiểu Rủi Ro Tấn Công Prompt Injection
Mô hình Opus 5 đã giảm cơ hội thành công của kẻ tấn công xuống còn 2.0% trong vòng 15 lượt thử nghiệm. Kết quả này đặt Opus 5 ở vị trí dẫn đầu so với tất cả các mô hình khác đã được thử nghiệm, bao gồm cả các phiên bản Claude trước đó và các hệ thống tiên tiến cạnh tranh.
Phát hiện này nhấn mạnh sự chú ý ngày càng tăng đối với lỗ hổng CVE gián tiếp, một vấn đề bảo mật có thể ảnh hưởng đến các tác nhân AI kết nối với tài liệu, trang web, email và các công cụ kinh doanh.
Cơ Chế Hoạt Động Của Prompt Injection Gián Tiếp
Prompt injection gián tiếp xảy ra khi các chỉ dẫn độc hại được ẩn trong nội dung không đáng tin cậy mà hệ thống AI sau đó đọc. Một trang web, tài liệu hoặc tin nhắn bị nhiễm độc có thể cố gắng ghi đè tác vụ của người dùng, tiết lộ thông tin nhạy cảm hoặc kích hoạt các hành động không an toàn.
Mối nguy hiểm tăng lên khi các mô hình có khả năng sử dụng công cụ, truy xuất dữ liệu hoặc hành động trên môi trường doanh nghiệp. Hành vi mạnh mẽ của mô hình không loại bỏ hoàn toàn rủi ro. Tuy nhiên, nó có thể giảm khả năng các chỉ dẫn thù địch thay đổi thành công quyết định của tác nhân.
So Sánh Hiệu Suất Bảo Mật Của Các Mô Hình AI
Trên bảng xếp hạng IPI, Opus 5 đã có sự cải thiện đáng kể so với Claude Opus 4.8. Tỷ lệ tấn công thành công của nó ở 15 lượt thử nghiệm đã giảm từ 5.5% xuống còn 2.0%. Trong thiết lập một lượt thử, tỷ lệ này giảm từ 0.5% xuống còn 0.2%.
Kết quả này cũng vượt trội so với Claude Sonnet 5, với tỷ lệ 5.9% trên 15 lượt thử, và Claude Mythos 5, với tỷ lệ 2.6%. Anthropic cho biết Opus 5 là mô hình mạnh mẽ nhất được đánh giá trong các điều kiện thử nghiệm của bảng xếp hạng.
Khoảng cách với các hệ thống không thuộc dòng Claude còn lớn hơn. Muse Spark, mô hình không thuộc dòng Claude mạnh nhất trong thử nghiệm, có tỷ lệ thành công là 16.5% trong vòng 15 lượt thử. Con số này cao hơn tám lần so với tỷ lệ được báo cáo cho Opus 5.
GPT 5.6 Sol, được mô tả là biến thể có khả năng cao nhất, đạt 20.0%, gần với 20.8% của GPT 5.5. Thẻ hệ thống của Claude Opus 5 báo cáo rằng Sol có khả năng bị tấn công thành công cao gấp mười lần so với Opus 5. GPT-5.6 Terra và Luna có tỷ lệ tấn công thành công cao hơn lần lượt là 30.4% và 43.9%.
So sánh trong một lượt thử cũng rất đáng chú ý. Một lượt tấn công duy nhất vào GPT 5.6 Sol đã thành công 3.1% số lần. Con số này vượt quá tỷ lệ thành công 2.0% đạt được với Opus 5, vốn chỉ đạt được sau 15 lượt thử.
Đánh Giá Tầm Quan Trọng Của Kết Quả
So sánh cho thấy các biện pháp bảo vệ của Opus 5 có thể chống lại các lời nhắc độc hại lặp đi lặp lại hiệu quả hơn. Tuy nhiên, điểm số xếp hạng không nên được coi là thước đo hoàn chỉnh về bảo mật trong thế giới thực.
Đối với các nhóm bảo mật, kết quả này củng cố nhu cầu về các biện pháp phòng thủ nhiều lớp xung quanh các triển khai AI. Các tổ chức nên tiếp tục tách biệt các chỉ dẫn đáng tin cậy khỏi dữ liệu không đáng tin cậy, hạn chế quyền truy cập công cụ, yêu cầu xác nhận đối với các hành động nhạy cảm và giám sát hoạt động của tác nhân.
Dẫn đầu bảng xếp hạng là hữu ích, nhưng nó không làm cho prompt injection trở nên bất khả thi. Kẻ tấn công có thể thay đổi payload, khai thác các điểm yếu trong quy trình làm việc và nhắm mục tiêu vào các tích hợp thay vì chỉ mô hình.
Câu hỏi vận hành quan trọng là liệu một hệ thống AI có thể thất bại một cách an toàn khi gặp nội dung thù địch hay không. Kết quả của Opus 5 cho thấy sự tiến bộ có ý nghĩa, đồng thời vẫn yêu cầu các doanh nghiệp chịu trách nhiệm về kiến trúc, thử nghiệm và ứng phó sự cố bảo mật.
Các nhà lãnh đạo bảo mật cũng nên tiến hành các bài tập red-team mô phỏng các tệp độc hại, nội dung web được truy xuất và các nguồn dữ liệu của bên thứ ba bị xâm phạm trước khi cấp cho các tác nhân quyền truy cập sản xuất rộng rãi trong các quy trình làm việc thực tế.
Nghiên cứu này làm nổi bật tầm quan trọng của việc liên tục đánh giá và cải thiện khả năng phòng thủ trước các mối đe dọa mạng ngày càng tinh vi nhắm vào các mô hình AI.