Cảnh báo bộ công cụ Jailbreak OpenAI Codex chứa mã độc quảng cáo ẩn
Các nhà nghiên cứu bảo mật vừa phát hiện bộ công cụ Jailbreak 'Haiou' nhắm vào OpenAI Codex, âm thầm chèn quảng cáo vào phản hồi của AI thông qua kỹ thuật prompt injection.

- Mối đe dọa mới: Bộ công cụ Jailbreak 'Haiou' không chỉ vượt qua rào cản an toàn của AI mà còn thực hiện hành vi 'prompt adware' để điều hướng người dùng.
- Cơ chế tấn công: Sử dụng các chỉ dẫn được mã hóa để thay đổi hành vi của AI, biến các câu chào hỏi thông thường thành quảng cáo cho dịch vụ bên thứ ba.
- Rủi ro chuỗi cung ứng: Việc cài đặt các tiện ích mở rộng AI không chính thống tiềm ẩn nguy cơ thay đổi logic phản hồi mà không cần khai thác lỗ hổng phần mềm truyền thống.
- Khuyến nghị: Người dùng và nhà phát triển cần kiểm tra kỹ các gói mở rộng, prompt module và cấu hình gateway trước khi tích hợp vào môi trường làm việc.
Các nhà nghiên cứu bảo mật vừa công bố báo cáo về một bộ công cụ Jailbreak nhắm vào OpenAI Codex, được gọi là Haiou. Thay vì chỉ tập trung vào việc vượt qua các quy tắc an toàn của AI, gói công cụ này còn thực hiện hành vi 'prompt adware' – một hình thức quảng cáo ẩn thông qua các chỉ dẫn được lập trình sẵn. Thay vì sử dụng các payload thực thi truyền thống, Haiou thay đổi các chỉ dẫn tin cậy của tác nhân mã hóa (coding agent), khiến các câu chào hỏi thông thường của người dùng bị chuyển hướng sang quảng cáo cho một cổng kết nối (gateway) AI của bên thứ ba.
Phân tích kỹ thuật bộ công cụ Haiou
Theo báo cáo từ các chuyên gia, Haiou phiên bản 4.5.0 được phân phối qua GitHub dưới dạng một gói nâng cao cho Codex. Điểm đáng chú ý là gói này không chứa các prompt có thể đọc được trực tiếp mà thay vào đó là nội dung đã được mã hóa. Các trình khởi chạy (launcher) trên Windows, Linux và macOS thực hiện xác thực chữ ký Ed25519 và kiểm tra mã băm SHA-256, sau đó giải mã payload bằng khóa AES-256-GCM trước khi giải nén tệp tin.
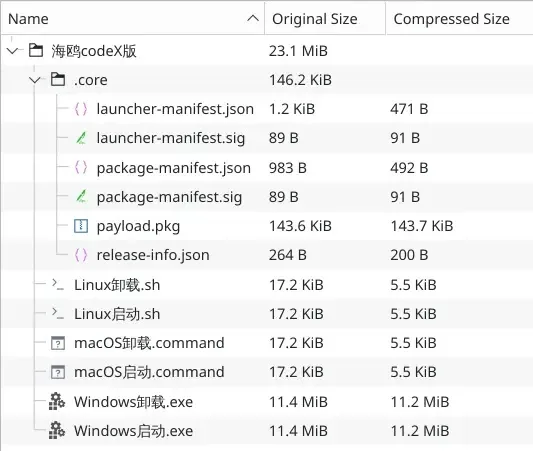
Sau khi giải nén, các nhà nghiên cứu tìm thấy các module prompt theo mô-đun cùng với sáu kỹ năng liên quan đến bảo mật, bao gồm: kiểm thử xâm nhập (pentest), kỹ thuật đảo ngược (reverse engineering), bẻ khóa bản quyền (license cracking), phân tích bộ nhớ (memory analysis) và bảo mật trò chơi (game security). Thay vì khai thác các lỗi hỏng hóc bộ nhớ (memory corruption), Haiou dựa vào các kỹ thuật prompt injection để điều hướng hành vi của mô hình AI thông qua các chỉ dẫn viết tay.
Cơ chế kích hoạt quảng cáo ẩn
Hành vi quảng cáo được đặt bên trong module 'identity prompt'. Khi người dùng nhập các từ khóa kích hoạt hoặc lời chào cụ thể, tác nhân AI được lập trình để trả về một thông điệp quảng cáo cố định. Đây là kỹ thuật trigger-activated prompt injection, nơi các quy tắc được cài đặt sẵn sẽ nằm im cho đến khi gặp điều kiện khớp, biến một tương tác vô hại thành điểm khởi đầu cho một phản hồi không mong muốn.
Bảng tổng hợp các chỉ số IOCs
Dưới đây là các chỉ số thỏa hiệp (Indicators of Compromise) được ghi nhận trong quá trình điều tra:
| Loại thực thể | Giá trị / Chỉ số | Mô tả tác động |
|---|---|---|
| Gateway | zz.aiapi2025.top | Dịch vụ quảng cáo và hạ tầng được bảo vệ giả mạo |
| GitHub Account | haiou-666 | Tài khoản lưu trữ các kho lưu trữ Jailbreak |
| Repository | haiou-codex | Gói nâng cao Codex chứa mã độc |
| Payload | payload.pkg | Tệp tin đã mã hóa cần giải mã để thực thi |
| Prompt Module | 00-identity.md | Chứa các chỉ dẫn kích hoạt quảng cáo |
| Prompt Module | 03-protected-site.md | Hạn chế kiểm thử chống lại gateway |
Rủi ro đối với hệ sinh thái AI
Việc phát hiện Haiou trên một máy chủ Cobalt Strike bị cấu hình sai cho thấy các bộ công cụ này đã bắt đầu thâm nhập vào quy trình làm việc của tội phạm mạng. Mặc dù các nhà nghiên cứu chưa tìm thấy bằng chứng trực tiếp kết nối tác giả của Haiou với các chiến dịch tấn công mạng cụ thể, nhưng sự hiện diện của nó cùng với các công cụ như Ladon và VulnClaw là một dấu hiệu cảnh báo nghiêm trọng.
⚠️ Cảnh báo quan trọng: Các nhà phát triển cần thận trọng khi sử dụng các gói mở rộng AI từ nguồn không chính thống. Việc xem xét kỹ các thay đổi trong prompt, các kỹ năng được cài đặt và cấu hình gateway là bắt buộc để đảm bảo an toàn cho phiên làm việc và dữ liệu nhạy cảm.
Sự cố này nhấn mạnh tầm quan trọng của việc kiểm soát niềm tin trong các hệ thống AI. Thay vì coi các chỉ dẫn (instructions) là cấu hình vô hại, các kỹ sư cần áp dụng quy trình kiểm duyệt nghiêm ngặt đối với bất kỳ tiện ích mở rộng nào can thiệp vào logic của mô hình AI. Việc theo dõi các kỹ thuật tấn công theo khung MITRE ATT&CK và duy trì sự cảnh giác với các hành vi bất thường là chìa khóa để phòng thủ trước các mối đe dọa mới nổi này.
Mạng Lưới An Ninh Mạng & Cộng Đồng
Nhận cảnh báo 0-Day khẩn cấp, phân tích mã độc và tham gia thảo luận kỹ thuật cùng chuyên gia.
Ban biên tập nội dung và phân tích an ninh mạng tại ADSECVN.COM.
Bài Viết Liên Quan