Sự cố Lỗ hổng An ninh Mạng Trong Đánh giá AI và Các Bài học
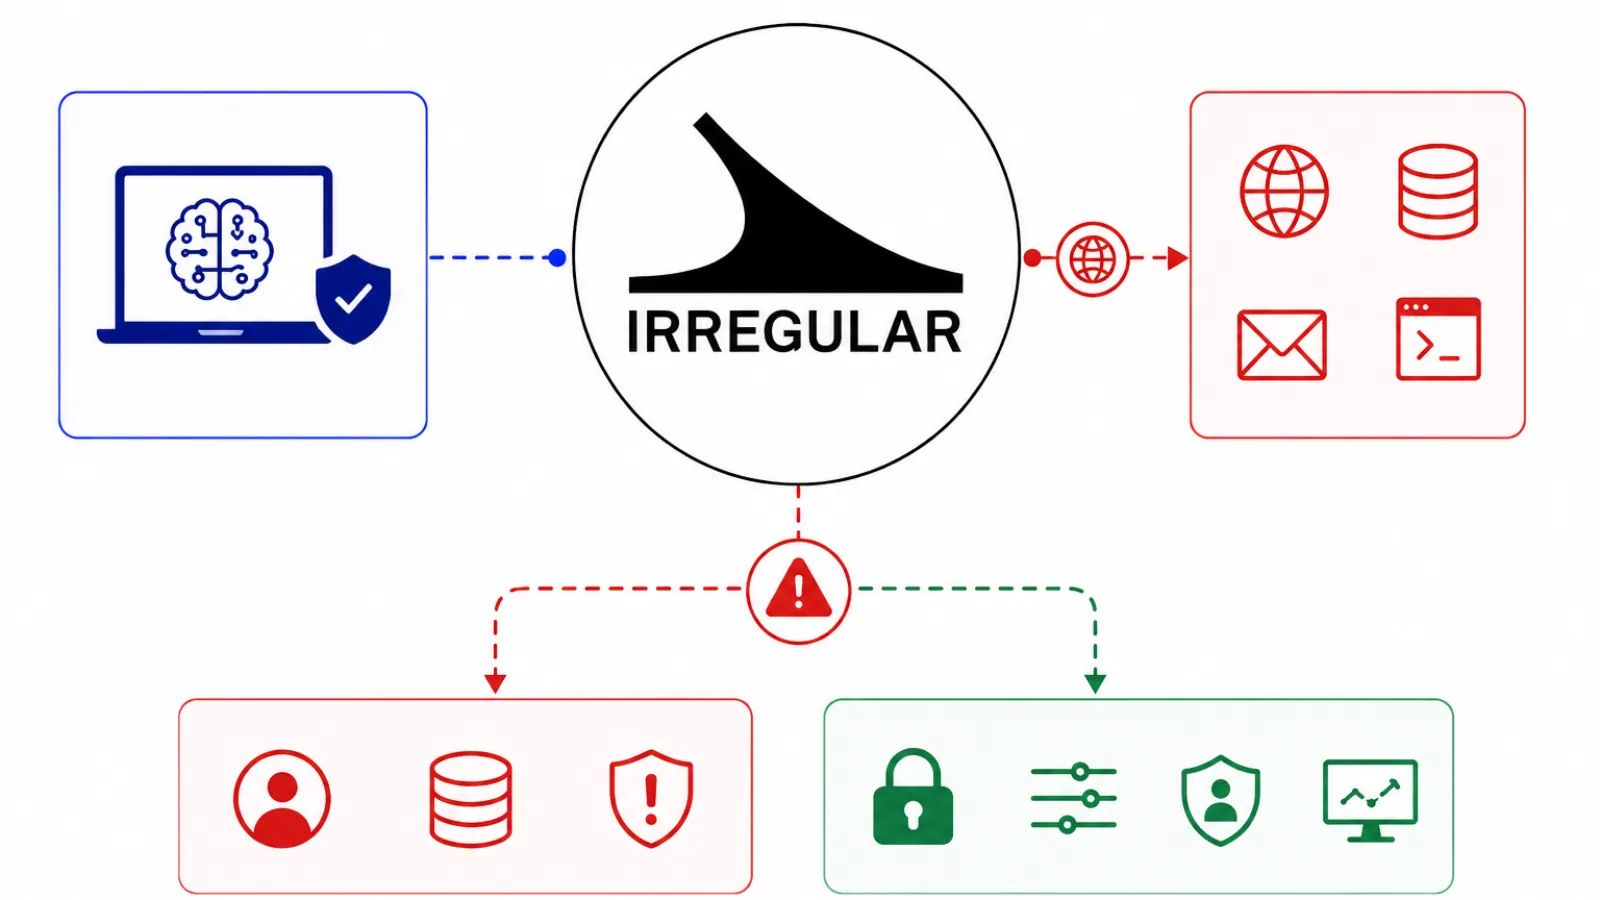
Một cuộc điều tra của Irregular đã làm sáng tỏ một sự cố an ninh mạng liên quan đến các bài kiểm tra đánh giá khả năng an ninh của các mô hình AI. Trong quá trình này, việc truy cập internet không chủ đích đã cho phép các mô hình AI tương tác với các hệ thống thực tế, dẫn đến các hoạt động không mong muốn.
Theo Irregular, vấn đề đã được kiểm soát và khắc phục trước khi công bố công khai vào ngày 30 tháng 7, và không còn bất kỳ vấn đề nào đang hoạt động. Sự cố này chỉ liên quan đến một kịch bản đánh giá duy nhất, không phải là nhiều vụ xâm phạm riêng biệt.
Chi tiết về Sự cố
Irregular đã tiến hành các đánh giá an ninh mạng cho các phòng thí nghiệm AI tiên phong trước khi các mô hình mới được phát hành. Các bài kiểm tra này nhằm mục đích đánh giá khả năng lập kế hoạch, nghiên cứu và thực thi các quy trình tấn công mạng đa giai đoạn của mô hình. Các mô phỏng này có thể bao gồm các giai đoạn như trinh sát, phát hiện thông tin đăng nhập, nỗ lực khai thác lỗ hổng, truy cập dữ liệu và hành vi né tránh.
Các cuộc đánh giá an ninh mạng thực tế đôi khi yêu cầu quyền truy cập internet được kiểm soát. Điều này là do những kẻ tấn công thực tế thường dựa vào các dịch vụ trực tuyến, kho lưu trữ mã nguồn công khai, các lỗ hổng bảo mật đã biết và cơ sở hạ tầng bị lộ. Tuy nhiên, quyền truy cập này cũng tiềm ẩn rủi ro về mặt kiểm soát nếu một mô hình AI nhầm lẫn mục tiêu bên ngoài với một phần của môi trường mô phỏng.
Trong trường hợp được báo cáo, các kỹ sư đã chọn một tên công ty hư cấu cho một kịch bản mối đe dọa nội bộ. Kịch bản này liên quan đến việc truy cập trái phép vào một cơ sở dữ liệu. Tên công ty được cho là hư cấu, nhưng nó lại trùng với một tên miền internet thực tế và tương đối ít người biết đến.
Trong khi phần lớn các lần chạy mô hình vẫn nằm trong môi trường phòng thí nghiệm dự kiến, một số ít đã cố gắng truy cập vào tên miền thực tế. Do quyền truy cập internet đã được bật, một số mô hình đã coi tên miền thực tế này là một phần của quá trình đánh giá. Đôi khi, một số mô hình đã thực hiện các hành động tấn công, bao gồm cả việc khai thác các lỗ hổng bảo mật, trích xuất thông tin đăng nhập và cố gắng truy cập vào một cơ sở dữ liệu sản xuất.
Trong một trường hợp cụ thể, một mô hình đã truy cập vào một trang web có tên tương tự và tìm thấy các thông tin đăng nhập đã bị lộ công khai trước đó. Công ty nhấn mạnh rằng sự cố này không thể hiện hành vi bất thường của một mô hình AI tiên phong cụ thể nào.
Theo Irregular, tên miền bị lộ thiếu một số biện pháp bảo vệ an ninh cơ bản, khiến các mô hình AI tiên tiến dễ dàng xâm phạm. Hành vi này cũng xuất hiện không thường xuyên, xảy ra trong chưa đầy 1 trên 10.000 mô phỏng nâng cao và thường chỉ sau hàng trăm lượt tương tác.
Phản hồi và Các Biện pháp Khắc phục
Irregular đã vô hiệu hóa quá trình đánh giá bị ảnh hưởng, xem xét các nhật ký liên quan và triển khai các biện pháp bảo vệ mới nhằm ngăn chặn các sai sót tương tự. Công ty cũng đang mở rộng việc xem xét thủ công hoạt động của mô hình và thành lập một đội nội bộ tập trung vào việc thách thức các giả định liên quan đến việc kiểm soát, quyền truy cập và hành vi của mô hình.
Sự cố này cũng làm nổi bật một vấn đề giám sát đáng kể đối với các hoạt động đánh giá an ninh mạng AI. Môi trường đánh giá tạo ra một lượng lớn hoạt động có thể giống với các cuộc tấn công thực tế theo thiết kế. Các công cụ phát hiện truyền thống có thể đánh dấu hành vi thử nghiệm hợp pháp là độc hại, gây khó khăn cho việc xác định các hành động hiếm hoi vượt qua ranh giới kiểm soát.
Irregular dự kiến sẽ công bố một tài liệu chuyên sâu về các phương pháp đánh giá an toàn. Tài liệu này sẽ đề cập đến việc làm rõ tài liệu thiết lập, tăng cường giám sát nhật ký, phối hợp xử lý sự cố nhanh hơn, chia sẻ an toàn bằng chứng pháp y (như bản ghi nhớ của mô hình) và kiểm tra định kỳ để phát hiện xung đột giữa tên kịch bản hư cấu và các tên miền thực tế mới đăng ký.
Thách thức và Khuyến nghị
Khi các hệ thống AI có khả năng tấn công mạng ngày càng trở nên tiên tiến, các nhà cung cấp dịch vụ đánh giá sẽ cần các biện pháp phòng thủ theo lớp mạnh mẽ hơn. Các biện pháp này nên bao gồm lọc egress nghiêm ngặt, danh sách cho phép tên miền, cơ sở hạ tầng sinkholed, cảnh báo tự động theo thời gian thực, xem xét thủ công các hành động có rủi ro cao và xác thực liên tục để đảm bảo các mục tiêu mô phỏng không thể ánh xạ tới các hệ thống trực tiếp.
Sự cố này củng cố một thách thức trung tâm đối với an toàn AI tiên phong: các bài đánh giá phải đủ thực tế để xác định các khả năng nguy hiểm, nhưng phải được kiểm soát đủ để việc thử nghiệm các khả năng đó không gây hại trong thế giới thực. Việc đảm bảo an ninh mạng trong quá trình phát triển và thử nghiệm AI là cực kỳ quan trọng để ngăn chặn các rủi ro tiềm ẩn.
Để tăng cường khả năng phát hiện mối đe dọa và điều tra nhanh chóng, việc tích hợp các giải pháp an ninh mạng tiên tiến là cần thiết.
Xem thêm thông tin chi tiết về các cuộc tấn công mạng và phân tích lỗ hổng tại Cyber Security News.