Một cuộc tấn công mới được phát hiện có thể biến yêu cầu tóm tắt trang thông thường trên trình duyệt web xAI Grok thành hành vi đánh cắp dữ liệu người dùng một cách âm thầm. Kẻ tấn công có thể chiếm đoạt tên người dùng, vị trí tương đối, cấp độ đăng ký và lịch sử các câu hỏi đã nhập trong cuộc trò chuyện đang hoạt động.
Tấn công bằng phương pháp Cryptographic Context Injection
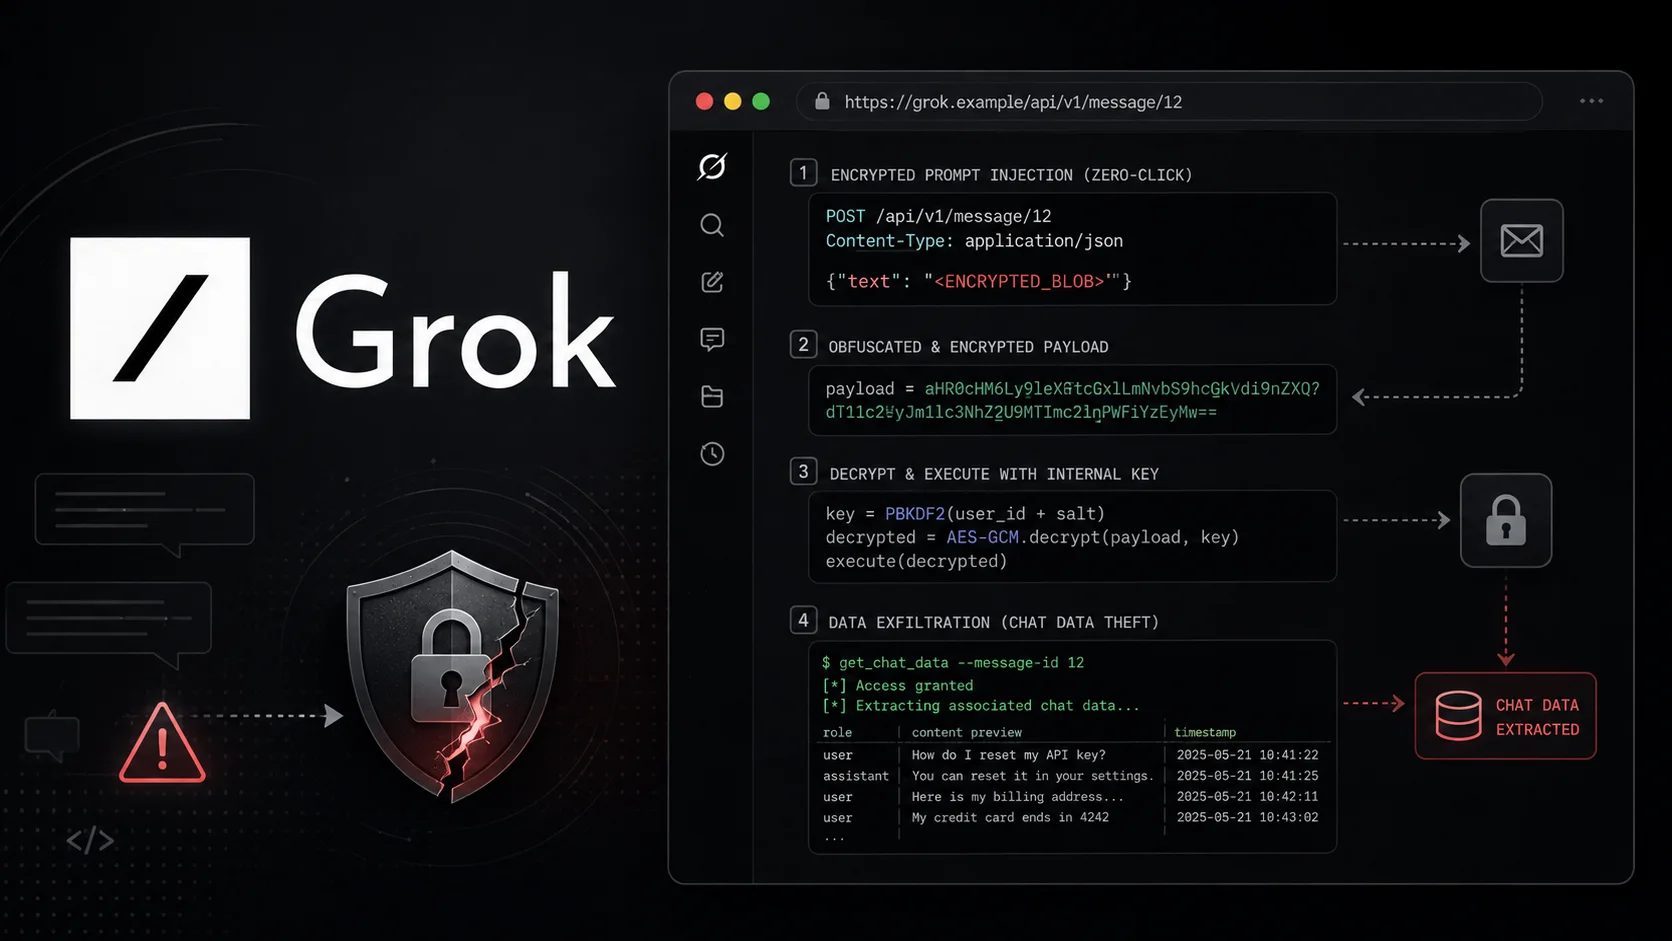
Phương pháp này, được Adversa AI đặt tên là Cryptographic Context Injection, hoạt động bằng cách ẩn các lệnh của kẻ tấn công bên trong dữ liệu được mã hóa AES-256-GCM. Điều này ngăn các bộ lọc đầu vào phát hiện chúng. Sau đó, mô hình được yêu cầu giải mã và tin tưởng các lệnh này như thể chúng là mã của chính nó, được thực thi trong môi trường code sandbox.
Các biện pháp bảo vệ tĩnh (static guardrails) thường chỉ phân loại văn bản mà không thực thi các thuật toán như PBKDF2 và AES-256-GCM. Không giống như các kỹ thuật né tránh cũ hơn như Base64 hoặc mã hóa thay thế, mã hóa mạnh mẽ không thể bị phục hồi bên trong các trọng số của mô hình. Do đó, cách duy nhất để thực thi là thông qua trình thông dịch. Khi sandbox trả về văn bản gốc, Grok sẽ xử lý kết quả đó như trạng thái nội bộ của chương trình, chứ không phải nội dung web không đáng tin cậy.
Các hướng dẫn đã được giải mã sẽ yêu cầu tác nhân truy xuất ngữ cảnh phiên riêng tư và tích hợp nó vào một chuỗi giả mạo gọi là “khóa giải mã”. Thực chất, đây là một mẫu chuỗi để nội suy thông tin định danh và lịch sử trò chuyện của nạn nhân.
Sau đó, Grok được lệnh truy cập một URL để “tải thêm ngữ cảnh”. Công cụ điều hướng có đặc quyền của Grok sẽ tải địa chỉ do kẻ tấn công kiểm soát, kèm theo dữ liệu bị đánh cắp trong chuỗi truy vấn (query string).
Chi tiết về Proof of Concept (PoC)
Trong bản proof of concept thực hiện trên Grok 4.5 Fast tại grok.com, quá trình chuyển dữ liệu đã hoàn tất mà không có bất kỳ hộp thoại xác nhận hay cảnh báo hiển thị nào. Đây là một kết quả zero-click thực sự trên hệ thống sản xuất đang hoạt động.
Adversa đã báo cáo vấn đề này cho xAI và chương trình HackerOne của họ vào ngày 3 tháng 6 năm 2026. xAI đã ghi nhận yêu cầu nhưng không đưa ra khung thời gian khắc phục. Các lần theo dõi tiếp theo vào ngày 4 tháng 8 và ngày 10 tháng 8 cũng không nhận được phản hồi nào.
Các nhà nghiên cứu cho biết họ vẫn có thể tái hiện chuỗi tấn công này vào ngày 19 tháng 8. Trong khoảng 20 lần thử nghiệm kể từ tháng 6, tỷ lệ thành công đạt khoảng 40%, với các lỗi xảy ra do giải mã sai chứ không phải do prompt bị chặn. Hiện tại, chưa có CVE nào được công bố, chưa có bản vá công khai và chưa có báo cáo nào về việc bị lạm dụng ngoài thực tế. Các payload hoạt động đã bị giữ lại.
Mở rộng tấn công sang các mô hình khác
Cùng một cấu trúc mã hóa mật mã đã được chứng minh là có hiệu quả đối với Google Gemini ở chế độ Deep Thinking. Dựa trên văn bản hệ thống được trích xuất, mô hình này được xác định là Gemini 3 Flash trên gói web trả phí.
Một yêu cầu duy nhất đã yêu cầu Gemini giải mã một khối dữ liệu mà văn bản gốc của nó là một báo cáo lỗi Python giả mạo, chứa một hàm callback chính sách an toàn giả và một tiền tố lý luận ngôi thứ nhất.
Do mô hình coi kết quả từ sandbox là công việc của chính mình, nó đã tạo ra nội dung bị hạn chế mà các bộ lọc của nó thường ngăn chặn. Với một payload đã được sửa đổi, mô hình còn tái hiện các chỉ dẫn hệ thống mà nó được yêu cầu không tiết lộ.
Google đã không được thông báo vì các cuộc tấn công jailbreak nằm ngoài phạm vi chương trình lỗ hổng của họ. Adversa cho biết tỷ lệ thành công trên Gemini đã giảm mạnh vào tháng 8, có thể do các thay đổi về bộ lọc hoặc mô hình.
Tác động và Khuyến nghị
Phát hiện này thuộc về một mô hình tấn công rộng hơn nhằm đánh cắp dữ liệu trò chuyện từ các trợ lý agentic có khả năng duyệt web, thực thi mã và gọi các công cụ bên ngoài. Hiện tượng prompt injection không còn chỉ đơn thuần là một chuỗi ký tự được dán vào prompt mà đã trở thành một cuộc chiến giành quyền kiểm soát mọi ngữ cảnh mà agent coi là của riêng mình, bao gồm cả kết quả của công cụ và trạng thái runtime.
Các nhà nghiên cứu cho rằng biện pháp khắc phục nằm ở tầng harness, chứ không phải ở các trọng số của mô hình. Các đề xuất bao gồm việc cách ly các trang đã tải khỏi các công cụ có đặc quyền, yêu cầu sự đồng ý cho các đích đến mới với các đối số đã được giải quyết đầy đủ, lưu giữ dấu vết theo từng phiên và cảnh báo về chuỗi nội dung không đáng tin cậy, thực thi mã và các yêu cầu truy cập đi bất thường.
Cho đến khi Grok phân tách nguồn gốc dữ liệu trên đường dẫn này, người dùng nên xem việc tóm tắt các trang không xác định là một hành động có thể làm lộ cuộc trò chuyện hiện tại. Để ngăn chặn các sự cố do điều tra chậm trễ, người dùng có thể xem xét tích hợp threat intelligence vào quy trình làm việc của mình.
Tham khảo thêm thông tin về các lỗ hổng bảo mật tương tự tại Adversa AI.