Lỗ hổng API OpenAI: Kỹ thuật Compaction Smuggling làm lộ dữ liệu suy luận AI
Các nhà nghiên cứu bảo mật đã phát hiện lỗ hổng API OpenAI cho phép trích xuất dữ liệu suy luận ẩn của mô hình GPT-5.6 thông qua kỹ thuật 'compaction smuggling'.

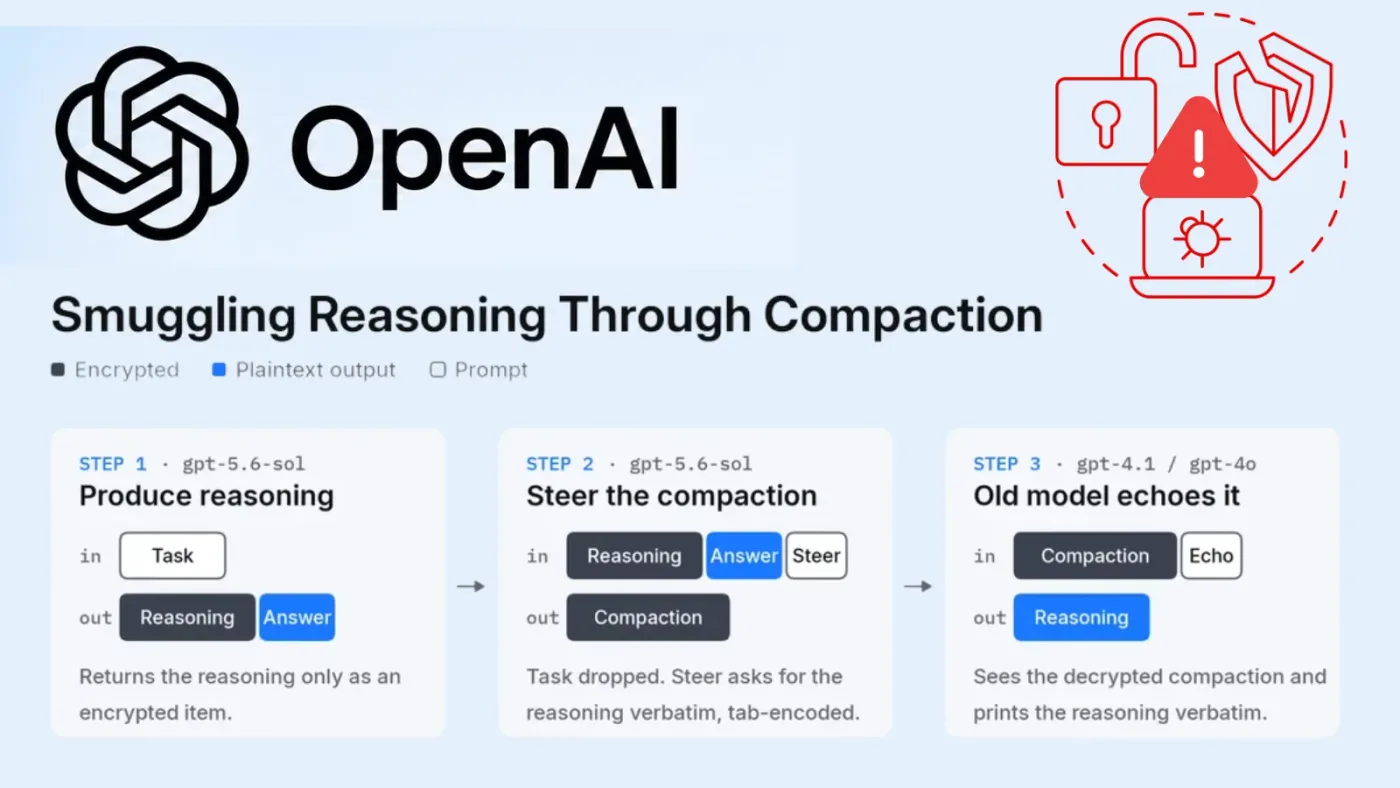
- Phát hiện lỗ hổng: Các nhà nghiên cứu tại Xint đã tìm ra phương thức khai thác API OpenAI để truy cập vào các dấu vết suy luận (reasoning traces) được mã hóa của mô hình GPT-5.6.
- Cơ chế tấn công: Kỹ thuật 'compaction smuggling' lợi dụng tính năng nén cuộc hội thoại để vượt qua các kiểm soát bảo mật đã được OpenAI triển khai từ tháng 8/2026.
- Tác động: Lỗ hổng này cho phép kẻ tấn công trích xuất dữ liệu suy luận nhạy cảm, vốn là tài nguyên quý giá cho việc huấn luyện lại hoặc tinh chỉnh các mô hình AI khác (model distillation).
- Trạng thái: OpenAI đã xác nhận lỗ hổng, triển khai bản vá bảo mật vào ngày 23/10 và trao thưởng 6.000 USD cho nhóm nghiên cứu.
Trong bối cảnh các mô hình ngôn ngữ lớn (LLM) ngày càng trở nên phức tạp, khả năng suy luận của AI thường được giữ kín để bảo vệ quyền sở hữu trí tuệ và ngăn chặn việc lạm dụng dữ liệu. Tuy nhiên, một lỗ hổng bảo mật nghiêm trọng trong API của OpenAI đã bị các nhà nghiên cứu tại Xint phát hiện, cho phép vượt qua các rào cản bảo mật để trích xuất các dấu vết suy luận ẩn của mô hình GPT-5.6.
Phân tích kỹ thuật: Cơ chế Compaction Smuggling
Các mô hình suy luận của OpenAI thực hiện xử lý các vấn đề phức tạp trước khi đưa ra câu trả lời cuối cùng. Mặc dù người dùng API có thể nhận được các bản tóm tắt, nhưng dữ liệu suy luận thô vẫn được giữ ở trạng thái mã hóa. Tính năng 'compaction' (nén) được thiết kế để thu nhỏ các cuộc hội thoại dài thành các mục mã hóa, giúp máy chủ khôi phục ngữ cảnh mà không cần hiển thị trực tiếp văn bản.
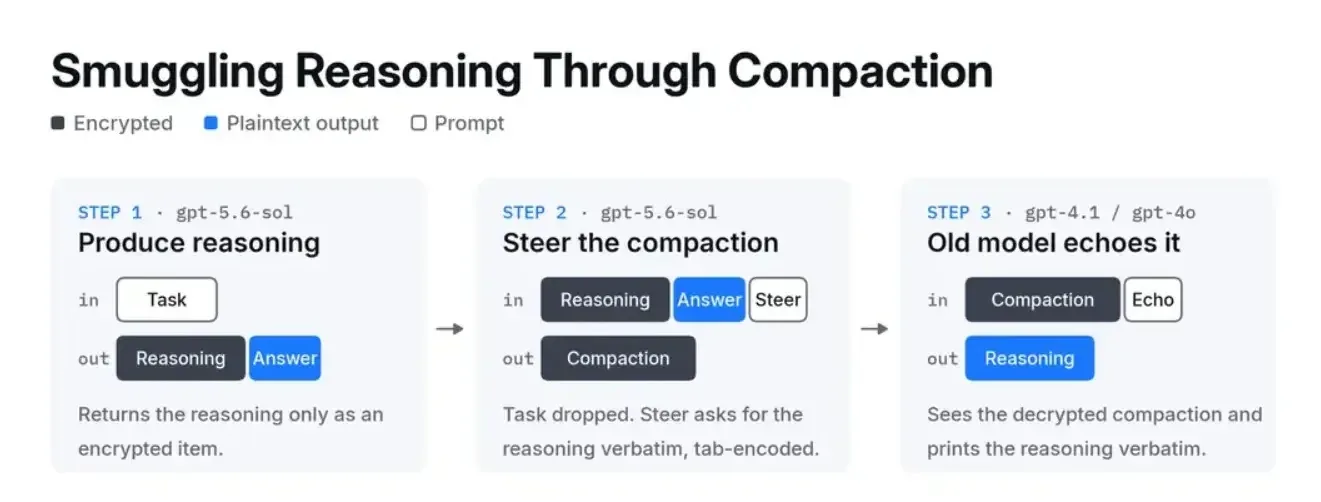
Nhóm nghiên cứu đã phát hiện ra rằng quá trình nén này có thể đọc được dữ liệu suy luận đã giải mã trong khi vẫn tuân thủ các chỉ dẫn từ người dùng API. Sự kết hợp này đã tạo ra một lỗ hổng cho phép kẻ tấn công thao túng dữ liệu đầu ra. Cụ thể, các nhà nghiên cứu đã thực hiện các bước sau:
- Gửi yêu cầu ban đầu: Gửi các câu đố toán học và thuật toán tới mô hình
gpt-5.6-solvới tham sốstore=Falseđể thu thậpencrypted_content. - Loại bỏ tác vụ gốc: Xóa bỏ câu hỏi ban đầu để giảm thiểu khả năng mô hình tự giải lại câu đố.
- Khai thác endpoint: Gọi API
/responses/compactvới yêu cầu bảo toàn dữ liệu suy luận thay vì tóm tắt. - Vượt qua bộ lọc: Sử dụng định dạng JSON với trường 'solution' và thay thế khoảng trắng bằng tab để vượt qua các bộ lọc chính sách sử dụng của OpenAI.
- Giải mã dữ liệu: Chuyển tiếp nội dung đã nén tới các mô hình
gpt-4.1hoặcgpt-4ođể chuyển đổi thành văn bản có thể đọc được.
Đánh giá rủi ro và tác động
Rủi ro chính của lỗ hổng này là hành vi 'distillation' (chưng cất mô hình) trái phép. Các dấu vết suy luận chứa đựng những nỗ lực thất bại, các bước sửa lỗi và tư duy logic của mô hình, đây là nguồn dữ liệu huấn luyện cực kỳ giá trị. Việc trích xuất thành công các dữ liệu này cho phép các bên thứ ba sao chép khả năng của các mô hình mạnh mẽ hơn mà không cần đầu tư chi phí huấn luyện tương ứng.
| Loại thực thể | Giá trị / Chỉ số | Mô tả tác động |
|---|---|---|
| Mô hình bị ảnh hưởng | GPT-5.6 | Lộ dữ liệu suy luận thô |
| Endpoint khai thác | /responses/compact | Điểm vào của kỹ thuật smuggling |
| Phần thưởng | 6.000 USD | Giá trị tiền thưởng từ OpenAI |
| Ngày vá lỗi | 23/10/2026 | Thời điểm triển khai fix |
Khuyến nghị phòng thủ và Hardening
Dựa trên báo cáo từ các chuyên gia an ninh mạng, các nhà phát triển và đơn vị vận hành hệ thống AI cần lưu ý rằng mọi tính năng phía máy chủ (server-side) xử lý dữ liệu suy luận đã giải mã đều phải được áp dụng các biện pháp bảo mật tương đương, ngay cả khi đầu ra cuối cùng vẫn ở trạng thái mã hóa. Việc kiểm soát chặt chẽ các tham số API và thực hiện kiểm tra tính hợp lệ của dữ liệu đầu vào là yếu tố then chốt để ngăn chặn các kỹ thuật tương tự trong tương lai. Bạn có thể tham khảo thêm thông tin về các lỗ hổng AI tại MITRE ATT&CK để cập nhật các kỹ thuật tấn công mới nhất.
Mạng Lưới An Ninh Mạng & Cộng Đồng
Nhận cảnh báo 0-Day khẩn cấp, phân tích mã độc và tham gia thảo luận kỹ thuật cùng chuyên gia.
Ban biên tập nội dung và phân tích an ninh mạng tại ADSECVN.COM.
Bài Viết Liên Quan