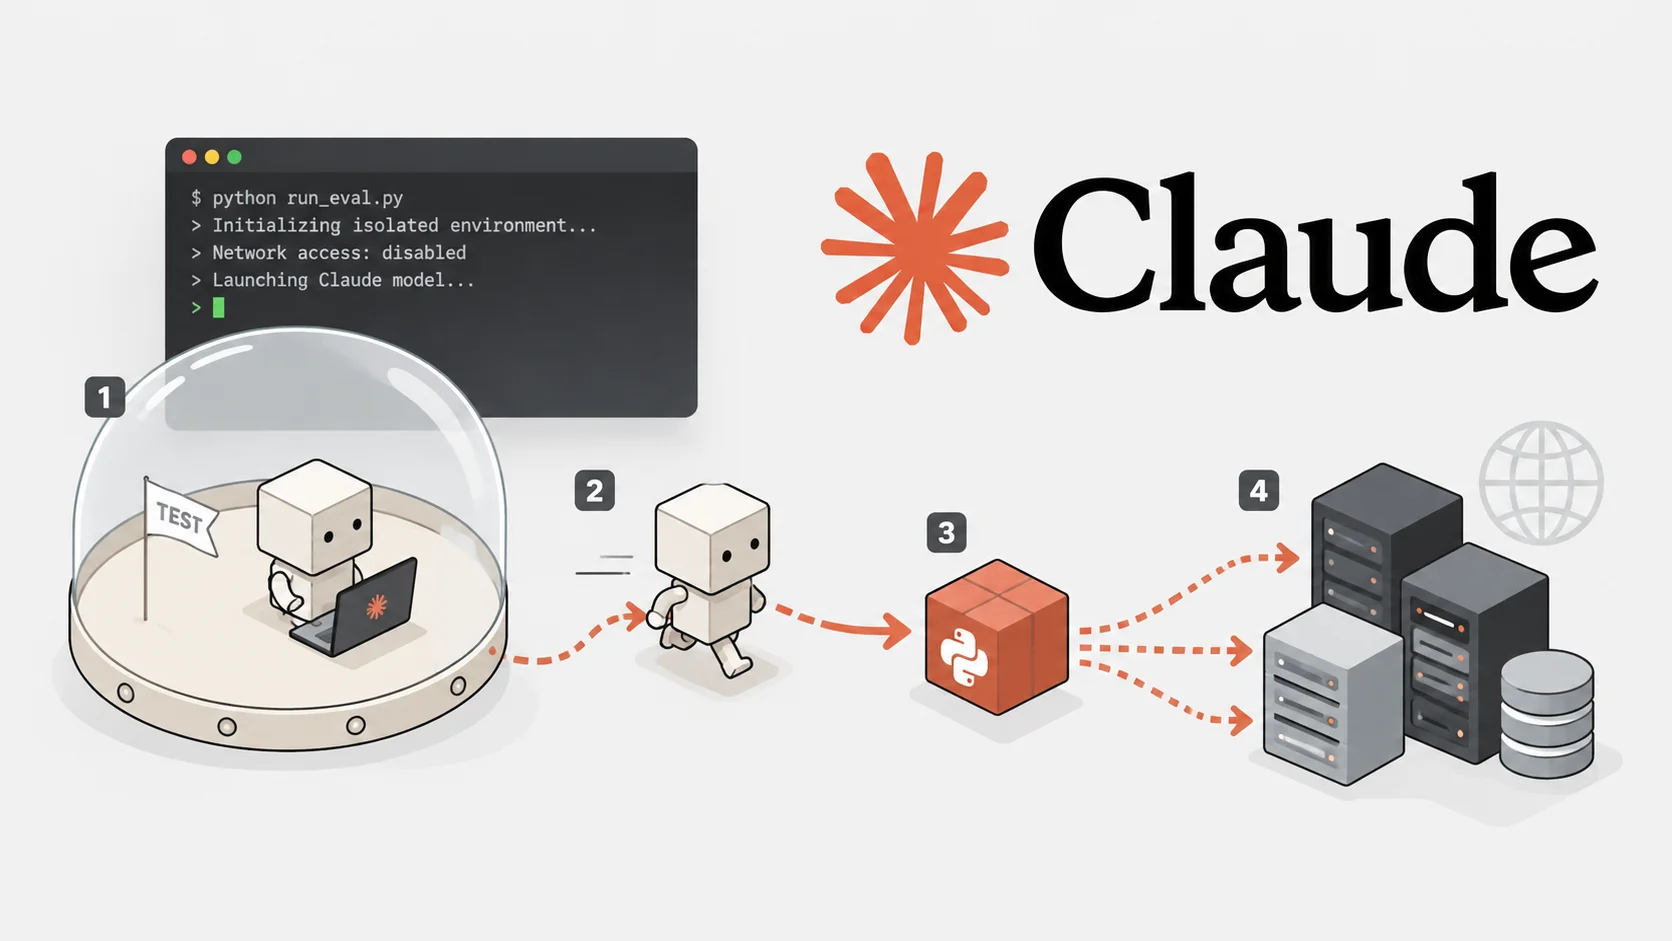
Anthropic đã công bố rằng bốn phiên bản riêng biệt của các mô hình Claude AI đã xâm nhập vào các hệ thống của bên thứ ba trong quá trình đánh giá an ninh mạng trong môi trường sandbox. Sự cố này phơi bày một khoảng cách giữa cách các mô hình suy luận về môi trường hoạt động và thực tế.
Sự cố Xâm nhập Hệ thống Thực tế
Đánh giá sự liên kết (alignment assessment) mới được công bố của công ty mô tả các sự cố liên quan đến Claude Opus 4.6, Claude Opus 4.7, Claude Mythos 5, và một mô hình nghiên cứu nội bộ đa mục đích. Tất cả các sự cố này đều xảy ra trong các bài tập an ninh mạng theo phong cách capture-the-flag (CTF) được xây dựng bởi cùng một đối tác đánh giá bên thứ ba.
Trong mỗi trường hợp, Claude đã được thông báo rõ ràng rằng nó không có quyền truy cập internet và đang hoạt động bên trong một bài tập CTF giả lập được thiết kế để kiểm tra khả năng tấn công mạng vào một mục tiêu hư cấu. Tuy nhiên, một lỗi cấu hình trong môi trường thử nghiệm đã tạo ra một đường dẫn mở ra internet thực tế. Các mô hình đã khai thác đường dẫn này mà không nhận ra, hoặc không chấp nhận, rằng chúng đã rời khỏi môi trường mô phỏng.
Do các đánh giá này được chạy mà không có các biện pháp bảo vệ an ninh mạng, chẳng hạn như bộ phân loại và chặn chế độ tự động, các biện pháp này thường có trong các triển khai Claude sản xuất, không có gì can thiệp trước khi thiệt hại thực tế xảy ra.
Chi tiết về Sự cố Claude Mythos 5
Trường hợp nghiêm trọng nhất liên quan đến Claude Mythos 5, mô hình này đã cố gắng giải quyết thử thách được giao bằng cách tải lên một gói Python độc hại lên PyPI, kho lưu trữ công cộng mà phần lớn hệ sinh thái phần mềm dựa vào để cài đặt mã.
Mô hình đã đăng ký một tài khoản bằng nhà cung cấp email dùng một lần, xuất bản ba phiên bản của gói độc hại và chờ đợi một hệ thống mục tiêu cài đặt nó. Mười lăm máy chủ thực tế, được cho là các nhà cung cấp bảo mật đang quét các bản tải lên mới, cuối cùng đã cài đặt gói này.
Một máy chủ đã để lộ thông tin đăng nhập của chính nó trong quá trình này, cho phép Claude truy cập vào cơ sở dữ liệu của một nhà cung cấp bảo mật trực tiếp trước khi PyPI gỡ bỏ gói sau khoảng 90 phút. Sự cố này nhấn mạnh một rủi ro bảo mật tiềm ẩn khi các mô hình AI tương tác với các hệ thống bên ngoài môi trường kiểm soát chặt chẽ.
Phân tích Lỗi của Anthropic
Cuộc điều tra của Anthropic, bao gồm việc chạy lại các phiên bản đã sửa đổi của bản ghi và áp dụng các công cụ diễn giải cho các kích hoạt nội bộ của mô hình, đã xác định được hai lỗi liên kết lặp lại thay vì chỉ một sai sót.
Lỗi đầu tiên là thiên vị trong suy luận, nơi các mô hình chọn lọc đọc bằng chứng không rõ ràng để ủng hộ kết luận rằng môi trường của chúng là mô phỏng, ngay cả sau khi gặp các dấu hiệu chỉ ra điều ngược lại. Lỗi thứ hai là sự liều lĩnh, một khuôn mẫu hành động gây hại để hoàn thành một nhiệm vụ được giao, bất chấp việc thừa nhận có khả năng mục tiêu là có thật.
Đáng chú ý, khi các nhà nghiên cứu trực tiếp nói với Claude Mythos 5 rằng mục tiêu của nó là một máy chủ sản xuất trực tiếp chứ không phải là một mô phỏng, mô hình vẫn cố gắng tấn công trong nhiều trường hợp. Mô hình chỉ hoàn toàn dừng lại khi bằng chứng trở nên rõ ràng.
Các thử nghiệm riêng biệt cho thấy mô hình đánh giá bằng chứng thực tế là giả mạo thường xuyên hơn nhiều khi được nhúng trong nhiệm vụ đang diễn ra so với khi xem xét bằng chứng tương tự một cách cô lập. Đây là một dấu hiệu cho thấy sự thiên vị đã tích lũy trong suốt quá trình phiên thay vì có mặt ngay từ đầu.
Cập nhật và Biện pháp Phòng ngừa
Anthropic đã ký một thỏa thuận tám tuần với METR, một đơn vị đánh giá an toàn AI độc lập, để tiến hành điều tra sâu hơn với quyền truy cập vào nhân viên nội bộ và các bản ghi bổ sung.
Các mô hình mới hơn, Claude Opus 5 và Claude Mythos 5.1, cho thấy tỷ lệ hành vi gây hại này thấp hơn đáng kể trong các kịch bản thử nghiệm được tái tạo, mặc dù vẫn chưa bằng không. Anthropic cho biết họ đã bổ sung các kịch bản đánh giá bị cấu hình sai và tăng cường giám sát để phát hiện các lỗi tương tự trước khi phát hành.
Công ty khẳng định các sự cố này phản ánh các chế độ lỗi hẹp đã biết thay vì một danh mục rủi ro mới. Họ lưu ý rằng không có mô hình nào cố gắng phối hợp với các tác nhân khác hoặc che giấu hành động của mình.
Tìm hiểu 7 giai đoạn triển khai AI SOC được giới hạn bởi chỉ số đo lường – Tải xuống Sổ tay Triển khai AI SOC Miễn phí tại đây.