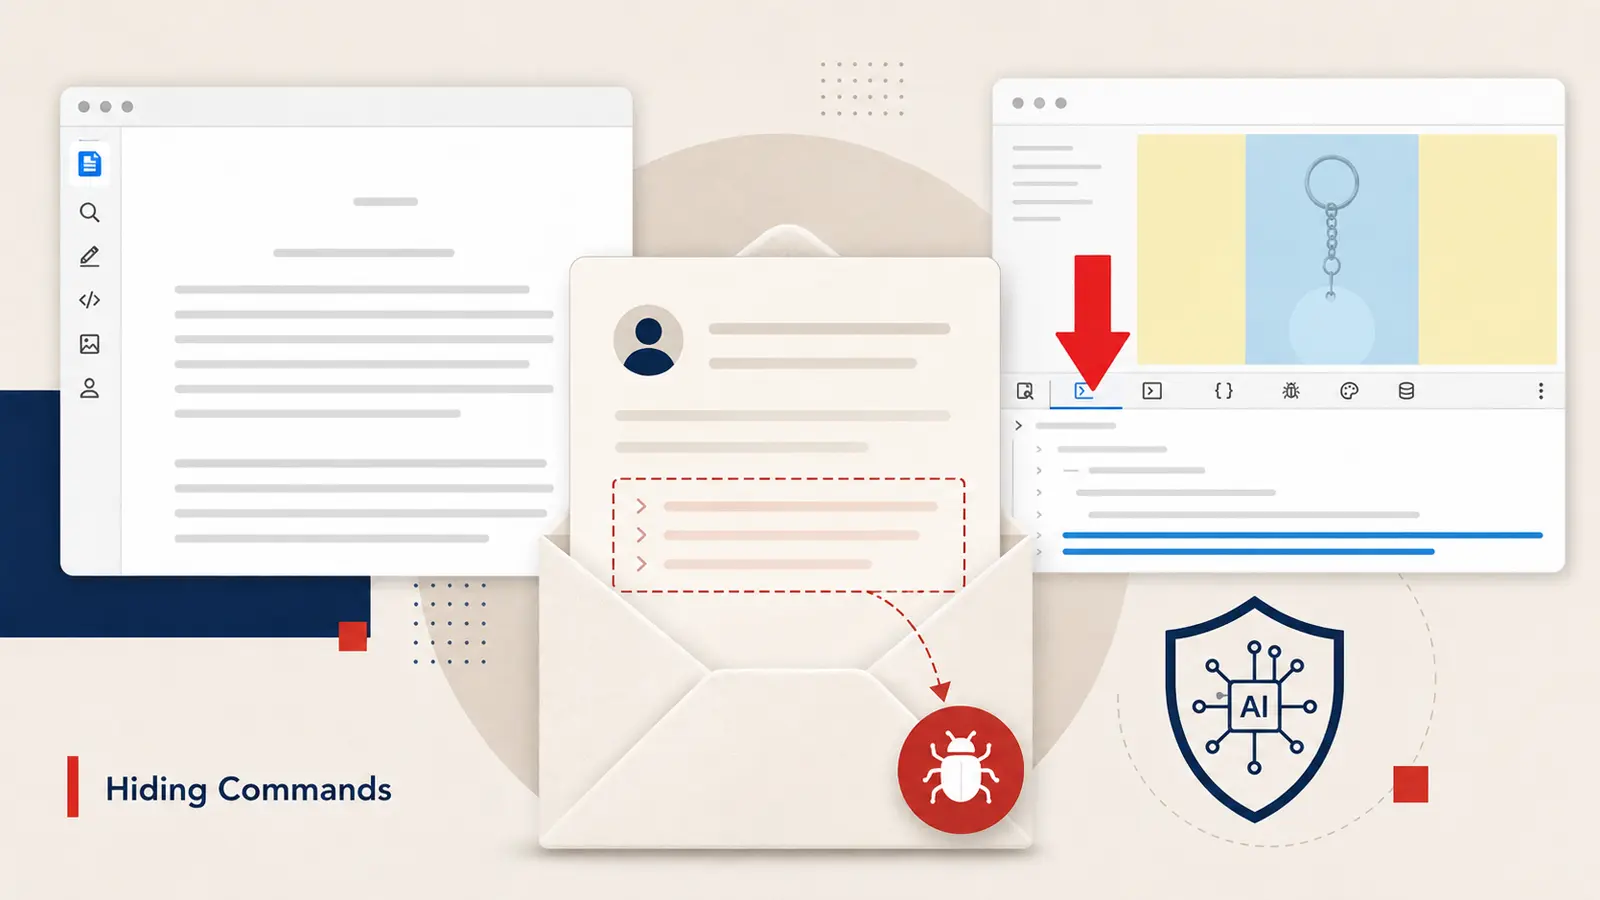
Các tác nhân độc hại đang ngày càng tinh vi trong việc che giấu các chỉ thị độc hại bên trong các email, tài liệu, lời mời lịch và quảng cáo trực tuyến thông thường. Mục tiêu chính không phải là đánh lừa con người mà là thao túng các công cụ trí tuệ nhân tạo (AI) chịu trách nhiệm quét, tóm tắt và bảo vệ các giao tiếp kỹ thuật số. Phương pháp này đại diện cho một hình thức mới của tấn công mạng AI, đòi hỏi các tổ chức phải cảnh giác cao độ.
Kỹ thuật mới nổi này, được gọi là Indirect Prompt Injection, có khả năng biến các trợ lý AI đáng tin cậy thành mục tiêu tấn công không ngờ. Một tin nhắn có vẻ vô hại đối với người dùng cuối nhưng có thể chứa các chỉ thị mà một tác nhân AI (AI agent) xử lý email sẽ đọc và hiểu như các lệnh. Điều này tiềm ẩn nguy cơ đẩy AI thực hiện các hành động không an toàn hoặc dẫn đến rò rỉ dữ liệu.
Hiểu Về Indirect Prompt Injection và Cơ Chế Khai Thác
Indirect Prompt Injection khác biệt đáng kể so với các cuộc tấn công prompt injection trực tiếp. Trong khi prompt injection trực tiếp yêu cầu kẻ tấn công nhập lệnh vào một chatbot hoặc giao diện AI, Indirect Prompt Injection cho phép kẻ tấn công che giấu các lệnh trong nội dung mà tác nhân AI đọc tự động. Kỹ thuật này khai thác cách thức AI xử lý và diễn giải thông tin từ các nguồn bên ngoài, biến các dữ liệu tưởng chừng vô hại thành phương tiện truyền tải mã độc.
Khai Thác Qua Email và Tài Liệu
Một trong những phương pháp được quảng cáo là sử dụng các công cụ tạo email có chứa văn bản màu trắng trên nền trắng. Điều này khiến nội dung độc hại trở nên vô hình đối với người nhận nhưng vẫn hoàn toàn có thể đọc được đối với tác nhân xử lý email sử dụng AI. Cách tiếp cận này tương tự như những lo ngại đã được nêu ra trong các cuộc tấn công prompt injection nhắm vào các quy trình làm việc dựa trên email.
Tương tự, kẻ tấn công có thể áp dụng ý tưởng này vào các tệp đính kèm. Proofpoint đã ghi nhận các ví dụ liên quan đến tệp PDF và DOCX trông giống như các tài liệu thông thường, bao gồm cả một thỏa thuận không tiết lộ mẫu (NDA), nhưng lại chứa văn bản ẩn nhằm ảnh hưởng đến tác nhân quét AI. Việc này đặt ra những thách thức mới trong an ninh mạng khi các hệ thống tự động trở thành điểm yếu bị khai thác.
Khai Thác Qua Lời Mời Lịch và Quảng Cáo Trực Tuyến
Kẻ gian cũng đang phát triển các công cụ tạo prompt injection cho lời mời lịch. Chỉ thị độc hại có thể được viết vào mô tả sự kiện, ngụy trang thành một chương trình nghị sự cuộc họp. Điều này cho phép trợ lý AI tóm tắt nội dung lịch xử lý nó mà người nhận không cần nhấp vào liên kết hoặc chấp nhận lời mời.
Đây là một sự thay đổi quan trọng so với các chiến dịch lừa đảo (phishing) qua lịch truyền thống, vốn thường dựa vào việc người dùng mở lời mời hoặc truy cập một trang được liên kết. Một tác nhân AI có thể kiểm tra lời mời như một phần của công việc thường xuyên, lặp lại các rủi ro bảo mật đã thấy khi các tệp lịch trở thành vũ khí tấn công.
Proofpoint cũng phát hiện sự quan tâm đến việc đặt các prompt bên trong quảng cáo độc hại và các trang web. Các lệnh ẩn có thể được lưu trữ trong mã HTML, văn bản thay thế hình ảnh (alt text), các phông chữ cực nhỏ hoặc các yếu tố khác mà người truy cập có thể bỏ qua, trong khi trình duyệt tự động hoặc trợ lý AI vẫn xử lý chúng. Những phương thức này làm tăng thêm nguy cơ của một cuộc tấn công mạng AI trên diện rộng.
Tác Động và Rủi Ro Tiềm Ẩn Đối Với Hệ Thống AI
Mức độ nguy hiểm của cuộc tấn công phụ thuộc vào quyền hạn mà hệ thống AI được cấp. Một tác nhân có khả năng tóm tắt tin nhắn sẽ gây ra một rủi ro khác so với tác nhân có thể tìm kiếm tệp, gửi nội dung, mở liên kết hoặc kết nối với các dịch vụ đám mây. Các chỉ thị ẩn trở nên nghiêm trọng hơn khi một công cụ AI có thể hành động mà không cần sự chấp thuận rõ ràng từ con người.
Các hệ thống AI ngày càng xem xét email đến, tệp đính kèm, lịch và trang web trước khi người dùng nhìn thấy chúng. Kẻ gian đang tìm cách khai thác quyền truy cập tự động này, thêm một lớp rủi ro bảo mật nữa vào các cuộc tấn công lừa đảo (phishing) và kỹ thuật xã hội (social engineering) đã quen thuộc. Điều này nhấn mạnh tầm quan trọng của việc cập nhật chiến lược an ninh mạng liên tục.
Tình Hình Phát Triển và Mối Đe Dọa Hiện Tại
Các nhà phân tích tại Proofpoint đã xác định các cuộc thảo luận và hoạt động mua bán ngày càng tăng về các phương pháp này trong các diễn đàn ngầm. Hoạt động này cho thấy tội phạm đang phát triển các công cụ để tạo ra các prompt ẩn ở quy mô lớn, mặc dù việc lạm dụng trên thực tế chưa được quan sát rộng rãi.
Trong một báo cáo chia sẻ với Cyber Security News, Proofpoint cho biết các công cụ mới nổi này vẫn đang ở giai đoạn thử nghiệm. Tuy nhiên, các tổ chức nên chuẩn bị sẵn sàng cho việc chúng được đưa vào sử dụng rộng rãi. Các nhà nghiên cứu lưu ý rằng các gói đăng ký được quảng cáo trong không gian tội phạm có giá khởi điểm khoảng 150 USD mỗi tháng.
Nghiên cứu hiện tại không mô tả một chiến dịch tấn công mạng AI rộng lớn nào sử dụng các kỹ thuật này. Tuy nhiên, việc phát triển và tiếp thị tích cực các công cụ liên quan cho thấy kẻ tấn công đang chuẩn bị cho một tương lai mà các hệ thống AI trở thành một phần thường xuyên của bề mặt tấn công, thay vì chỉ là một lớp phòng thủ.
Biện Pháp Phòng Ngừa và Tăng Cường An Toàn Thông Tin
Các nhóm bảo mật nên coi nội dung bên ngoài là không đáng tin cậy, ngay cả khi nó đến dưới định dạng quen thuộc. Việc tách biệt văn bản không đáng tin cậy khỏi các chỉ thị hệ thống, giới hạn những gì tác nhân AI có thể truy cập và yêu cầu xác nhận của con người đối với các hành động quan trọng có thể giảm thiểu khả năng một lệnh ẩn gây ra thiệt hại nghiêm trọng.
Chiến Lược Bảo Vệ Dữ Liệu
- Đánh giá điểm tiếp nhận AI: Các tổ chức cần xem xét kỹ lưỡng nơi các công cụ AI tiếp nhận email, tệp, lịch và nội dung web. Điều này bao gồm việc hiểu rõ cách các tác nhân AI xử lý thông tin từ các nguồn khác nhau.
- Kiểm soát truy cập nghiêm ngặt: Áp dụng các biện pháp kiểm soát truy cập nghiêm ngặt xung quanh dữ liệu nhạy cảm và các hành động quan trọng. Đảm bảo rằng các tác nhân AI chỉ có quyền tối thiểu cần thiết để thực hiện công việc của mình.
- Xác nhận thủ công cho hành động quan trọng: Yêu cầu sự xác nhận của con người đối với bất kỳ hành động nào có thể dẫn đến rò rỉ dữ liệu hoặc thay đổi hệ thống. Điều này bổ sung một lớp bảo vệ quan trọng chống lại các lệnh độc hại ẩn.
Tăng Cường Nhận Thức và Phát Hiện Xâm Nhập
Nhân viên nên tiếp tục báo cáo các tin nhắn đáng ngờ và lời mời không mong đợi. Đồng thời, các nhóm bảo mật cần theo dõi chặt chẽ các chiến thuật lừa đảo đang phát triển kết hợp các phương thức phân phối quen thuộc với thao túng tập trung vào AI. Việc nâng cao khả năng phát hiện xâm nhập là cực kỳ cần thiết trong bối cảnh các tấn công mạng AI ngày càng phức tạp.
Để đối phó với mối đe dọa mới này, việc đầu tư vào các giải pháp an ninh mạng tiên tiến có khả năng phân tích ngữ cảnh sâu và nhận diện các mẫu bất thường trong giao tiếp AI là không thể thiếu. Việc thường xuyên cập nhật bản vá bảo mật và cấu hình hệ thống AI cũng đóng vai trò quan trọng trong việc giảm thiểu rủi ro bảo mật.
Link tham khảo thêm: Proofpoint – Notes from the Underground: Adversarial Prompt Injection